器数维新 | DRG 3.0 分组器实战——一个 silent 兜底规则如何骗走 1467 条病案,以及我从政策理念到三层漏斗引擎的完整建造记
[!ABSTRACT] 核心摘要
项目:DRG 3.0 分组器(从国家医保局 2025 版分组方案到本地真实 HIS 数据全流程)
领域:医疗信息化 · 医保支付 · 规则引擎 · DSL
核心指标:1480 条规则 / 633 个集合 / 870 个 DRG 子组 / 单病案分组 < 5ms / 8 月份 2069 份病案 99.4% 成功分组
三条主线:
- 政策理念篇——3.0 改革的本质是什么,为什么必须自建规则引擎
- 架构与坑篇——三层漏斗 + 手写 DSL + 证据链,以及 7 个让人想骂街的工程坑
- silent bug 篇——一个
_safe_deserialize的 silent fallback 如何吞掉 1467 条病案,以及我是怎么把它修掉的
目标篇幅:12000-15000 字
核心隐喻:把医保局的 xlsx 规则文件,变成可以”对话”的解释器;让每一份病案都能”告诉医生,它为什么被分到这一组”
主编前言:为什么一个骨科医生要死磕 DRG 分组器
狼叔做了 10 年质管办工作,经手过 DRG 1.0、2.0、3.0 三代改革。
2025 年 9 月,国家医保局发布《按病组(DRG)付费 3.0 版分组方案配置信息.xlsx》——这是一份看似普通的 Excel 文件,但它背后的政治和经济含义不亚于一场地震:
- 覆盖范围扩张:从 376 个核心 DRG 组(ADRG)扩张到 628 个,几乎覆盖了所有住院病种
- 编码体系切换:从”国临版 2.0”全面切换到”医保版”,一些常见手术的医保版编码与临床版完全不同
- 权重重新洗牌:神经外科、骨科、心血管这些”高权重”专科,3.0 版普遍下调 10-20%;而儿科、产科、精神科普遍上调
- 质控指标挂钩:DRG 入组错误率、CMI、低倍率病例占比,直接进入医院绩效”国考”评分
狼叔所在医院是一家地市级三甲,骨科、心内、神经外是支柱科室。3.0 切换的窗口期只有 3 个月——
如果 3 个月内不能在新规则下把全院病案跑通,医保拒付的资金缺口将达数千万。
狼叔花了 1 周时间评估了市面上的所有方案:
| 方案 | 优点 | 缺点 |
|---|---|---|
| 商业 DRG 系统(东软、卫宁、创业等) | 上线快、有服务 | 黑盒、贵、按例收费、规则升级依赖厂商 |
| 国家医保局官方 DRG 分组器 | 权威 | 仅命令行、无前端、无 HIS 对接、无批量 |
| 第三方开源(类似 chinapvg) | 免费 | 代码老旧(2.0 版),不支持 3.0 新集合 |
没有一条路是”既要、又要、还要”的。
狼叔做了一个”疯狂”的决定:自己从零搭一个。
从 2025 年 10 月到 2026 年 9 月,11 个月,5400 行代码,从 xlsx 解析到前端可视化,从 DSL 设计到证据链,从 HIS 数据接入到 silent bug 修复——
这一期《器数维新》,献给所有”想自己掌握 DRG 命脉”的医院信息人。
Part 1 政策理念篇:DRG 3.0 到底改了什么,为什么我们必须自建规则引擎
1.1 三个必须理解的底层逻辑
(1) DRG 不是”分组游戏”,是”支付游戏”
很多人把 DRG 当成”病案首页的分类标签”——大错特错。
DRG 的核心是预付制:医保局给每个 DRG 组定一个”权重 × 点值 = 支付金额”,医院收一个病人,不管实际花多少,都按这个金额结算。
例:某 DRG 组权重 1.5,当季度点值 8000 元 → 医保支付 12000 元
如果实际花费 15000 元 → 医院亏 3000 元
如果实际花费 9000 元 → 医院结余 3000 元
所以分组错了,就是直接的经济损失。
(2) 3.0 版的”编码革命”:医保版 ≠ 临床版
这是 3.0 最让临床医生崩溃的变化:
例:膝关节置换术
- 国临版 2.0 编码:
81.5400或81.5500- 医保版 3.0 编码:
39.9000x021(完全不同的章节!)
如果 HIS 沿用国临版编码,直接喂给医保版规则引擎,分组率会跌到 30% 以下,医院等于白干。
(3) 规则文件每年都会变,商业系统是”被动升级”
医保局每年都会微调规则:新增 DRG 子组、调整集合、修订排除表。如果依赖商业系统,每次升级都是一次博弈——厂商说”要加钱”,医院说”上次不是送的吗”。
只有自建,才能让规则升级变成”改一份 xlsx + 重启服务”这么简单。
1.2 三个绕不开的工程挑战
理解了上述逻辑后,自建规则引擎要回答三个工程问题:
- 怎么表达规则? ——不能用代码硬编码(
if 诊断 == 'A00' then MDCA),因为规则有几万条;需要一种专门给非程序员看的 DSL。 - 怎么解释规则? ——DSL 字符串怎么变成可执行的判断?需要一套自研的 lexer + parser + AST + 解释器。
- 怎么证明分组正确? ——医保局、临床科主任、病人都可能质疑”为什么这单分到 X 组”。必须给出每一步的证据链。
这三个问题,构成了整个项目的骨架。
1.3 核心理念:规则即数据,逻辑/数据/引擎三层分离
狼叔参考了欧阳艾老师的《从 3.0 规则文件到 DRG 分组器》(就是项目根目录里的那份启发文档),确立了一个核心理念:
6 张业务表只承载数据,规则字符串只承载逻辑,Python 代码只承载解释执行。
这意味着:
- 改规则不需要改代码——xlsx 改一行,重启服务即可
- 审计只看数据——医保局检查时,把所有规则和集合导出就是完整的判定逻辑
- 不同医院可以共享引擎——只要换一份 xlsx
这个理念,在项目里体现在三个具体的”不做”上:
| 不做 | 原因 |
|---|---|
| 不在 Python 代码里写”if 诊断 in […]” | 那等于把规则写进代码,违反”规则即数据” |
| 不引入第三方解析器(Lark、PLY) | 我们的 DSL 只有 8 种终结符,手写 parser 更可控、证据更易挂载 |
| 不缓存”哪条规则命中”的中间结果到代码 | 缓存放到 AST JSON 列,启动时一次性构建,运行时不依赖任何业务逻辑 |
Part 2 架构篇:三层漏斗 + 手写 DSL + 证据链——一个解释器是怎么炼成的
2.1 总体架构:5 层栈
1 | ┌─────────────────────────────────────────┐ |
前端不需要”聪明”,它只负责”提问”;后端的核心是”解释器”。
2.2 SQLite Schema:6 张业务表 + 3 张辅助表
数据库的 9 张表按”业务隔离”原则设计:
业务表(直接对应 xlsx):
mdc_rules(27 行):大病组规则adrg_rules(537 行):核心病组规则drg_rules(870 行):细分组规则set_members(38,203 行):集合成员(编码 → 集合编号)cc_list(7917 行):CC 分级(MCC 1580 + CC 6337)exclusion_tables(21,037 行):排除表明细
病案与结果表:
cases:入院病案主表case_results:分组结果(每次 sync 一行,保留历史)batch_jobs:批量任务进度
关键设计:parsed_ast 列把 DSL 字符串预编译为 JSON,启动时一次性构建索引,运行时 json.loads 直接复用——单病案分组 < 5ms。
2.3 三层漏斗:M DC → ADRG → DRG,每一层都是”按优先级找首个命中”
DRG 分组的本质是逐层缩小范围:
1 | [所有病案] 10000+ |
每一层都是同一种模式:
1 | def match_first(rules, case, ctx, evidence_stage): |
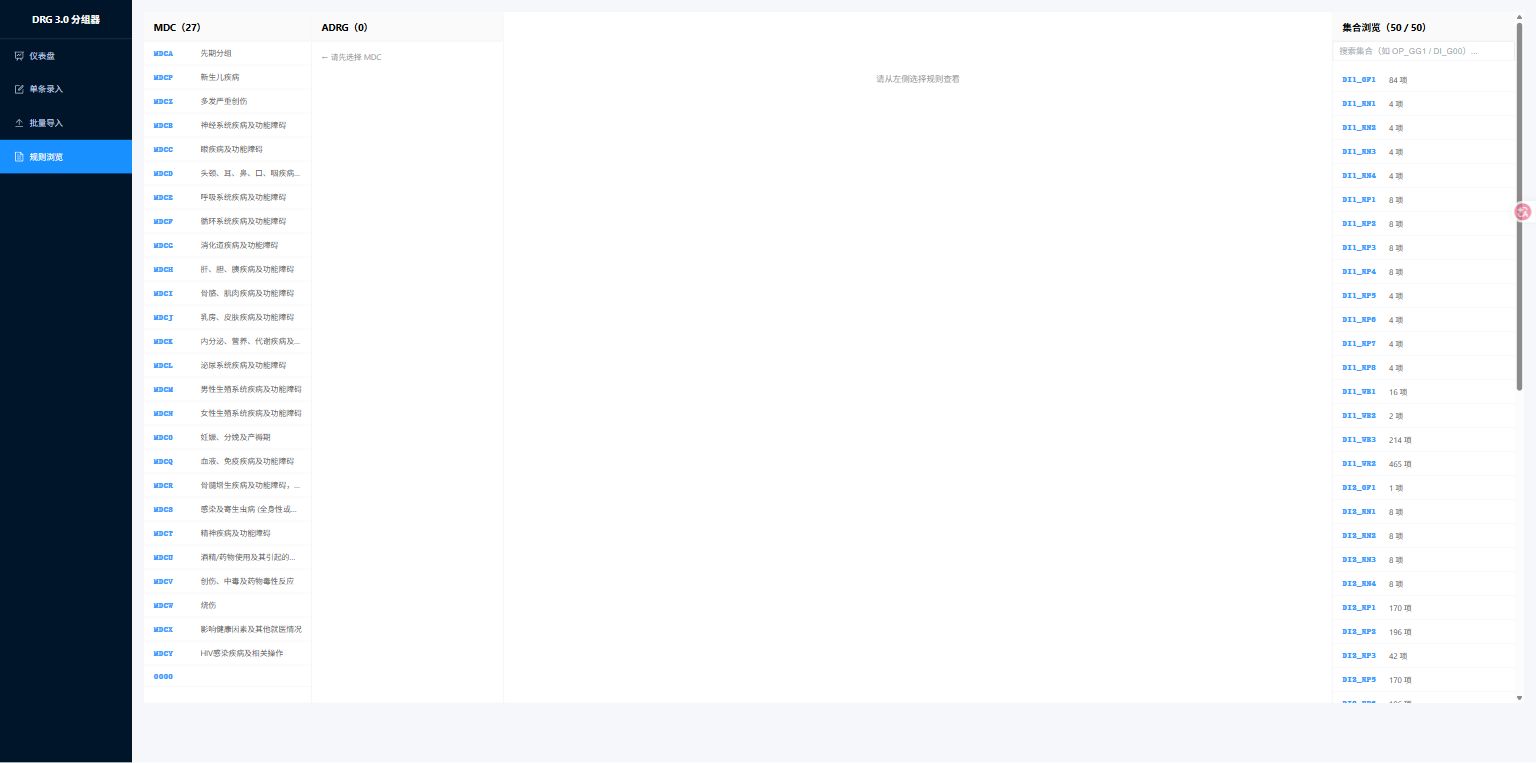
图 1:规则浏览页——左侧 27 个 MDC,中间 ADRG(选 MDC 后展开),右侧集合列表。
每一层的兜底都很重要:
- MDC 没命中 → 兜底 “0000”,error_type =
fallback - ADRG 没命中 → 兜底 “0000”,error_type =
fallback - DRG 没命中 → 兜底 “0000”,error_type =
fallback
兜底率是核心监控指标——正常医院应 < 5%,超过这个值,要么是数据质量出问题,要么是规则引擎有 bug。
2.4 手写 DSL:为什么不用 Lark/PLY
医保版的规则字符串长这样:
1 | ZYZD in DI_B00 |
4 种元素:
- 变量:
ZYZD/ZYSS/QTZD/NL/XB/XSRTL/XSRTZ/CC_LEVEL - 集合:
DI_B00/OP_AA1/MCC/CC—— 引用一张 38,203 行的编码表 - 运算符:
in/not in/=/>=/<=/>/< - 逻辑:
and/or/not
Lexer 只需要 8 个 Token 类型,Parser 用递归下降就够。
如果引入 Lark 或 PLY:
- 多 1 个第三方依赖(版本兼容地狱)
- 错误信息不可控——xlsx 里有 typo,定位不到行号
- AST 节点无法直接挂
evidence_id(证据链核心)
所以狼叔选择了纯手写,代码量约 600 行,但带来的灵活性是无价的:
1 | # parser.py 核心结构 |
2.5 证据链:申诉场景的”刚需”
狼叔在与医保局打交道的过程中,深刻体会到一件事:分组结果不是”算出来”就完事了,必须能”说出来”。
举个例子:某病案分组到 ES45,医生质疑:”为什么不是 ES43(伴并发症)?”
没有证据链,我们只能说”系统算的”;有证据链,我们可以说:
1 | DRG → ES45 (呼吸系统感染/炎症,不伴合并症或并发症) |
这就是证据链。
证据链的实现方式:AST 节点携带 evidence_id,解释执行时往栈式 context 写入。
1 | # evaluator.py 核心 |
短路与完整性平衡:OrNode 左侧 True 时右侧不再求值,但右侧仍记录为 not_evaluated——比”求值了但 False”更精准。
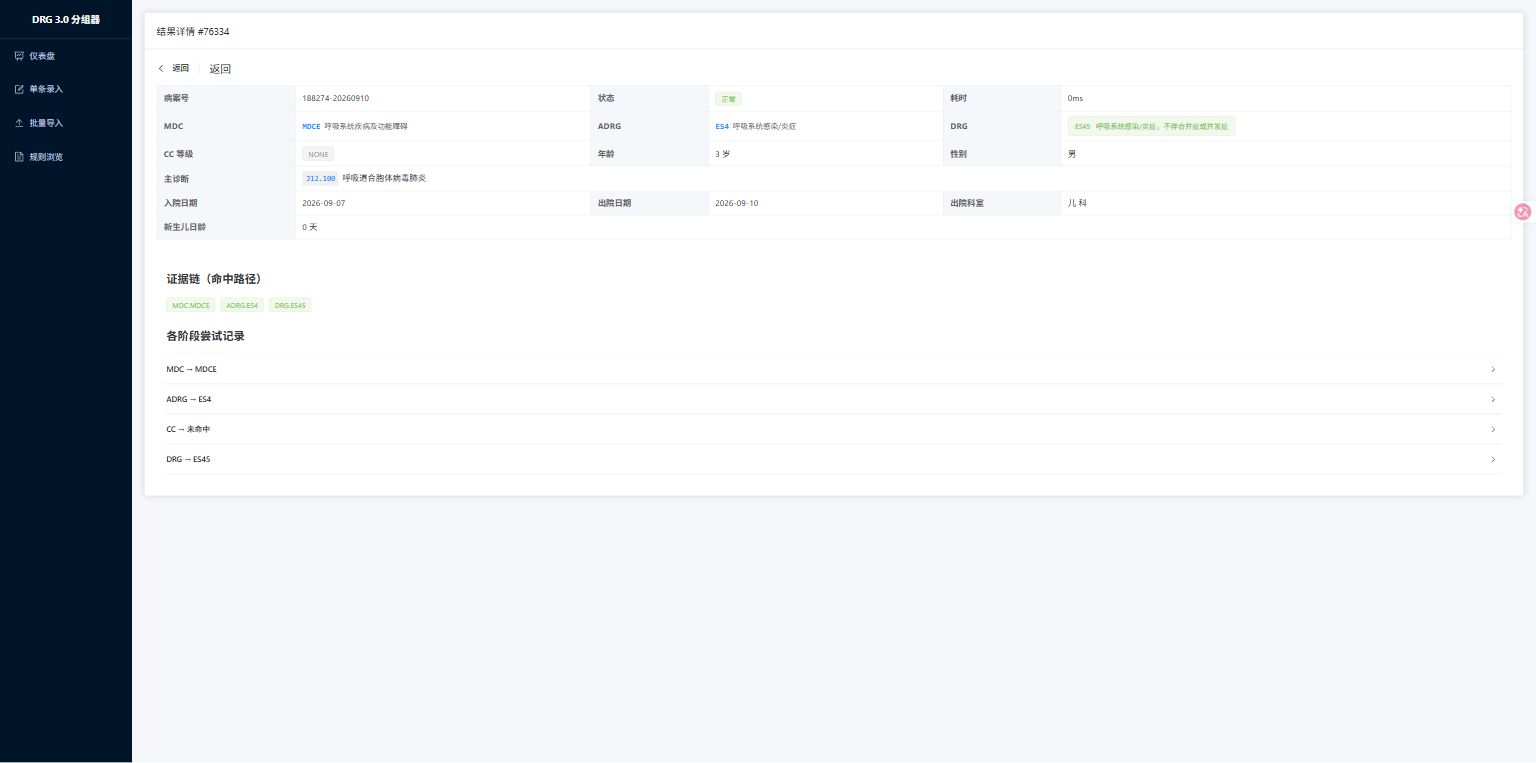
图 2:证据链总览——病案 #76334,3 岁男孩,主诊断 J12.100,4 个 stage 全部命中。
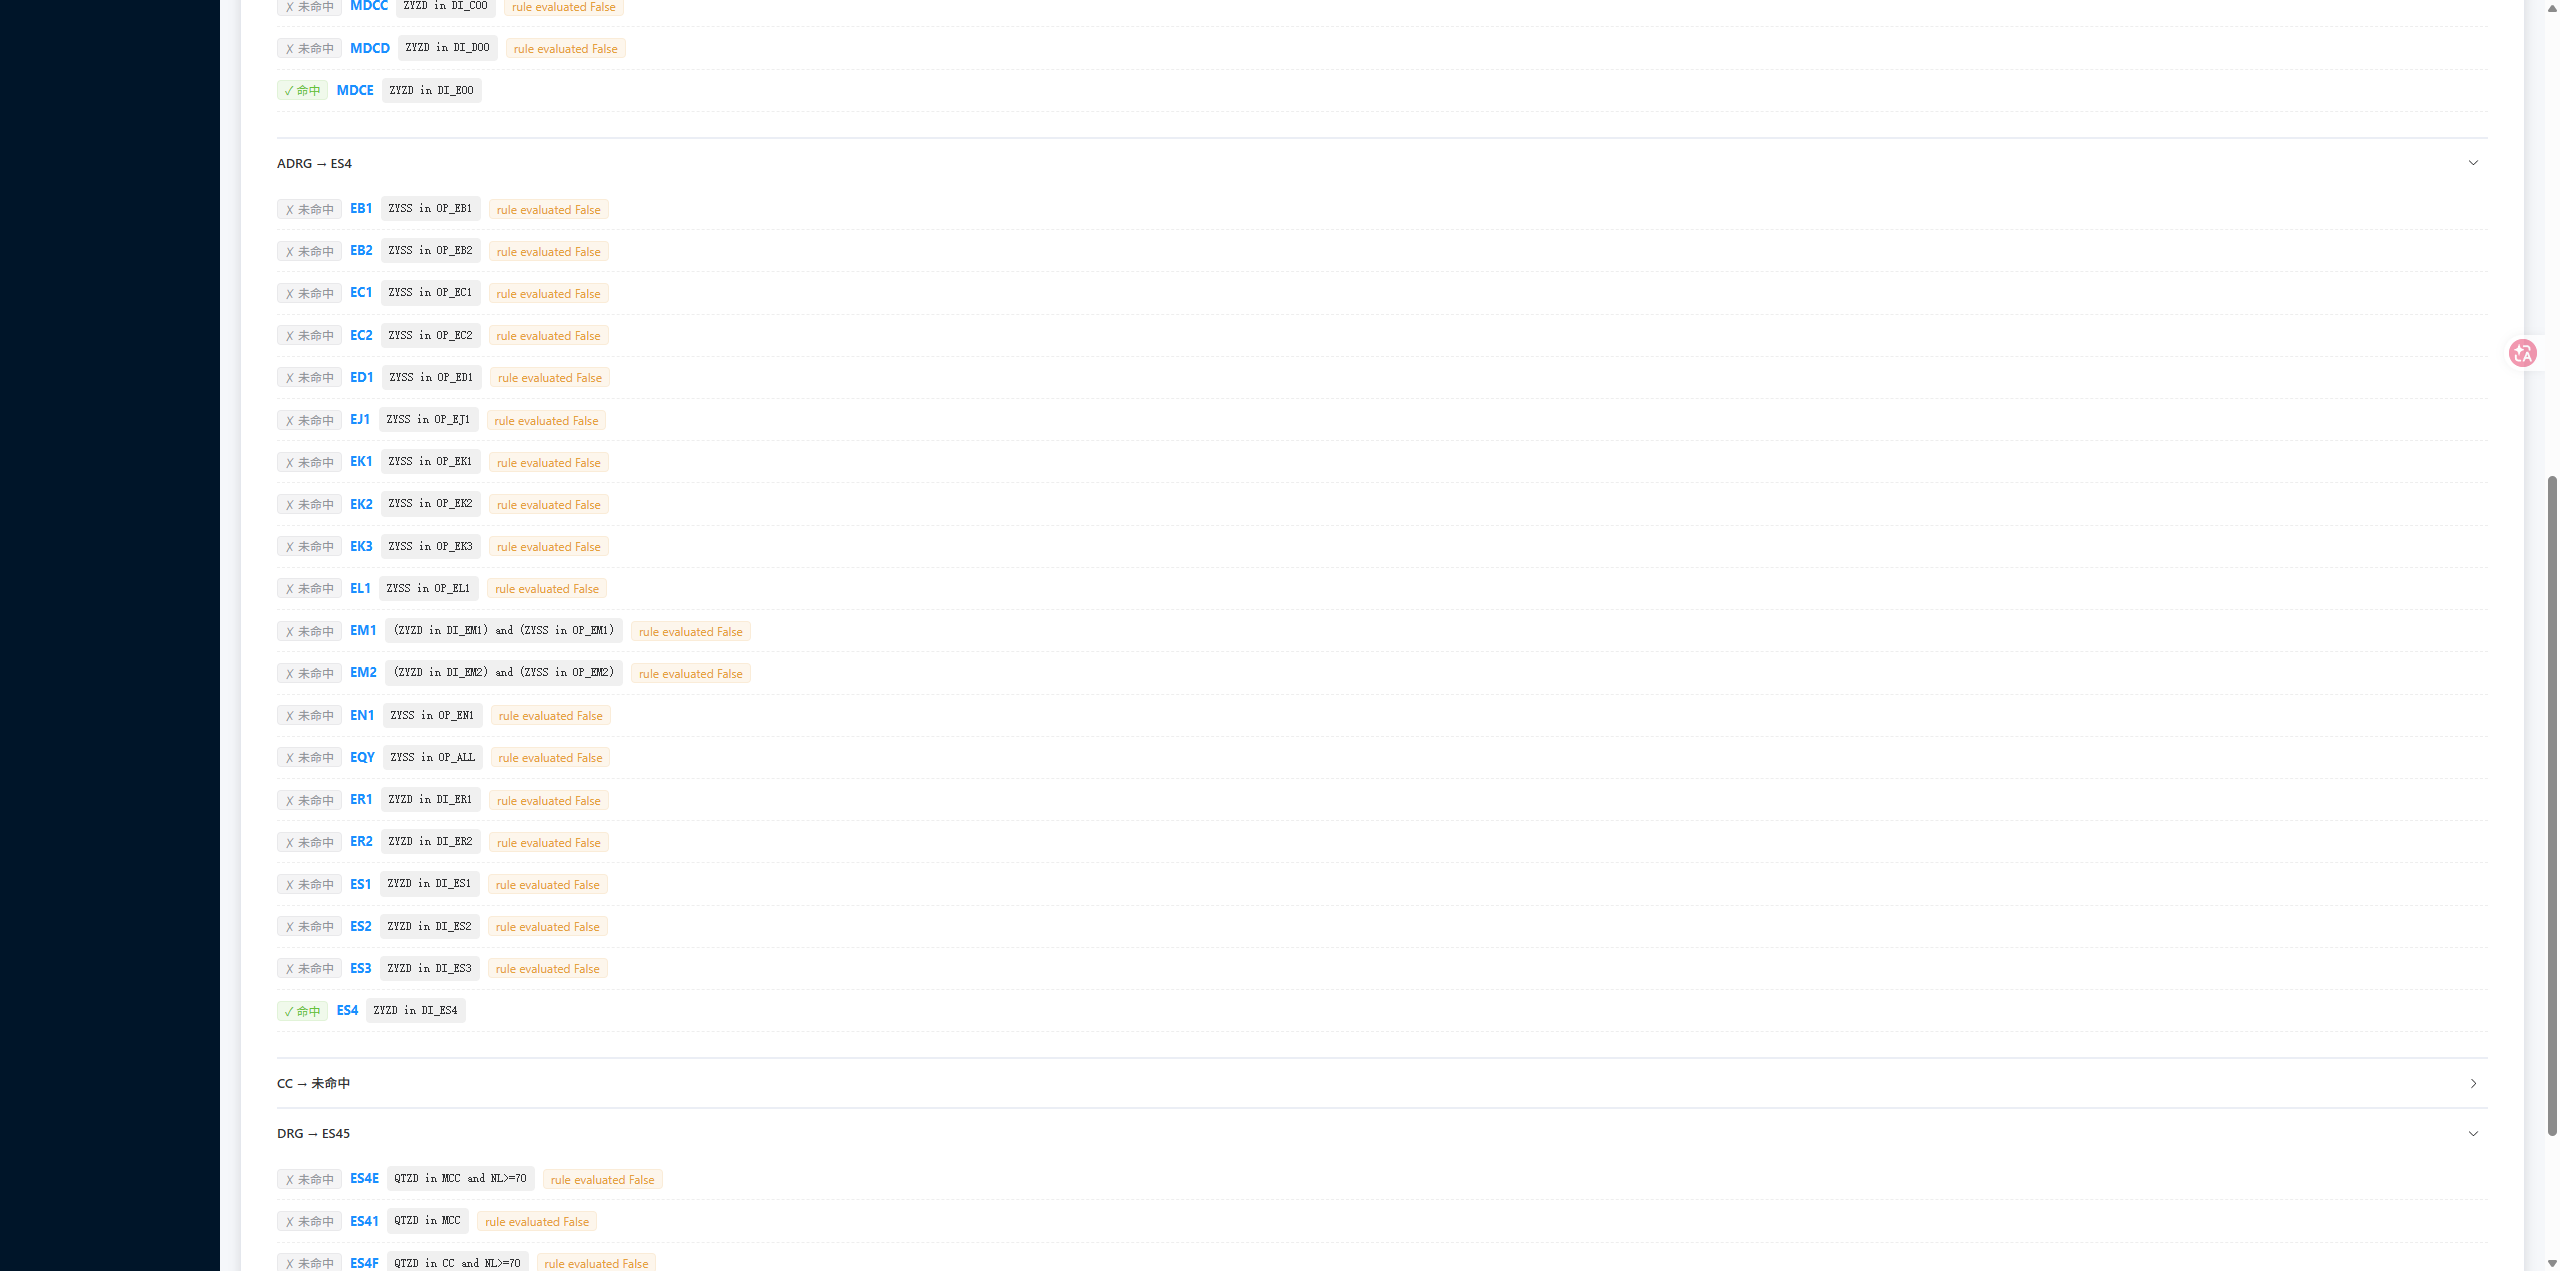
图 3:三个 stage 完全展开——MDC 层尝试 6 条规则(MDCP/MDCZ/MDCB/MDCC/MDCD 未命中,MDCE 命中),ADRG 层尝试多条,DRG 层尝试多条。每条规则都标注了 raw_expr 和 matched 状态。
2.6 单条录入 → 即时分组:毫秒级反馈
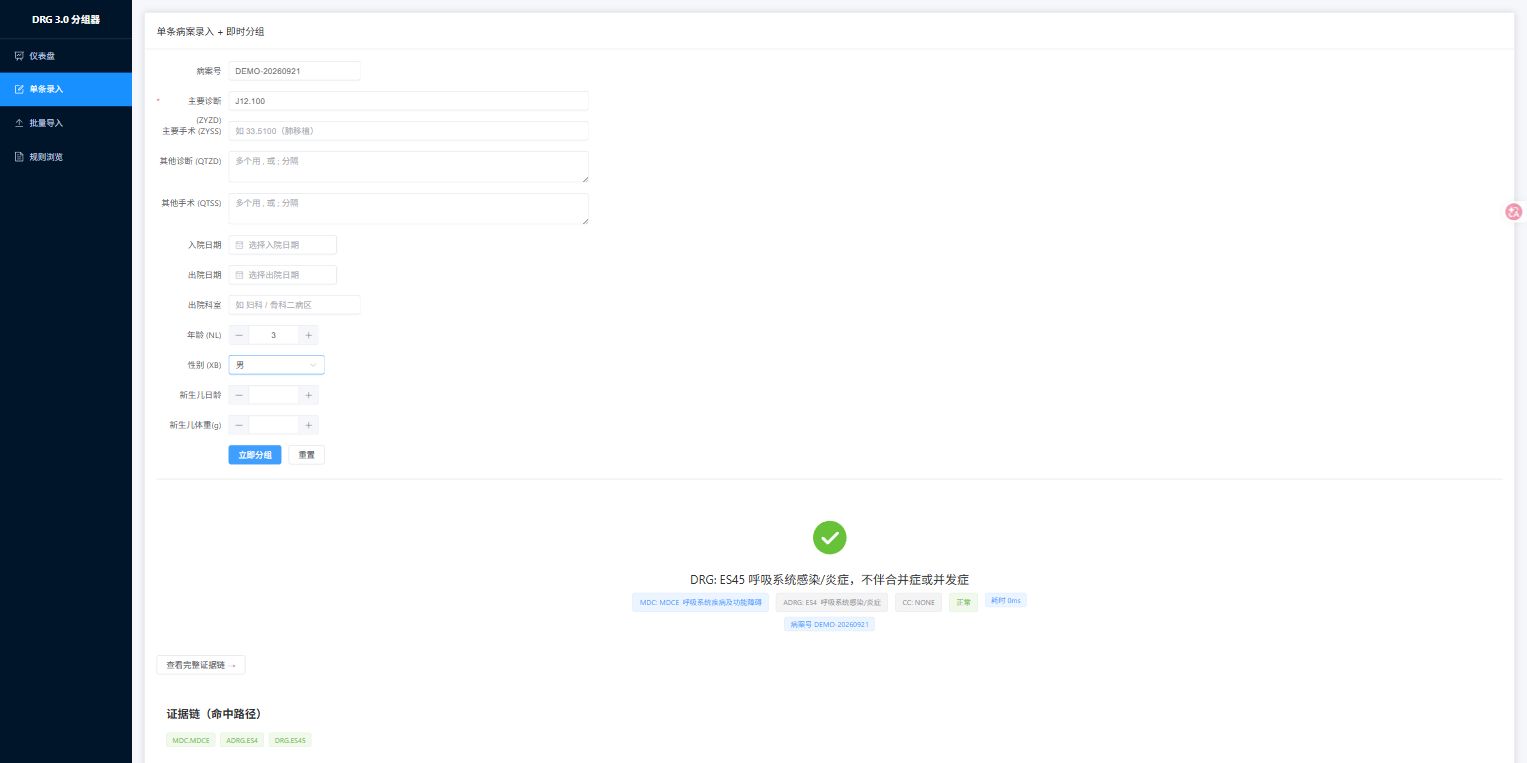
图 4:单条录入 + 即时分组——填入主诊断、年龄、性别,点”立即分组”0ms 返回结果,同时展开证据链。这对临床医生来说,是教科书级的体验:所见即所得。
2.7 仪表盘:兜底率是核心监控指标
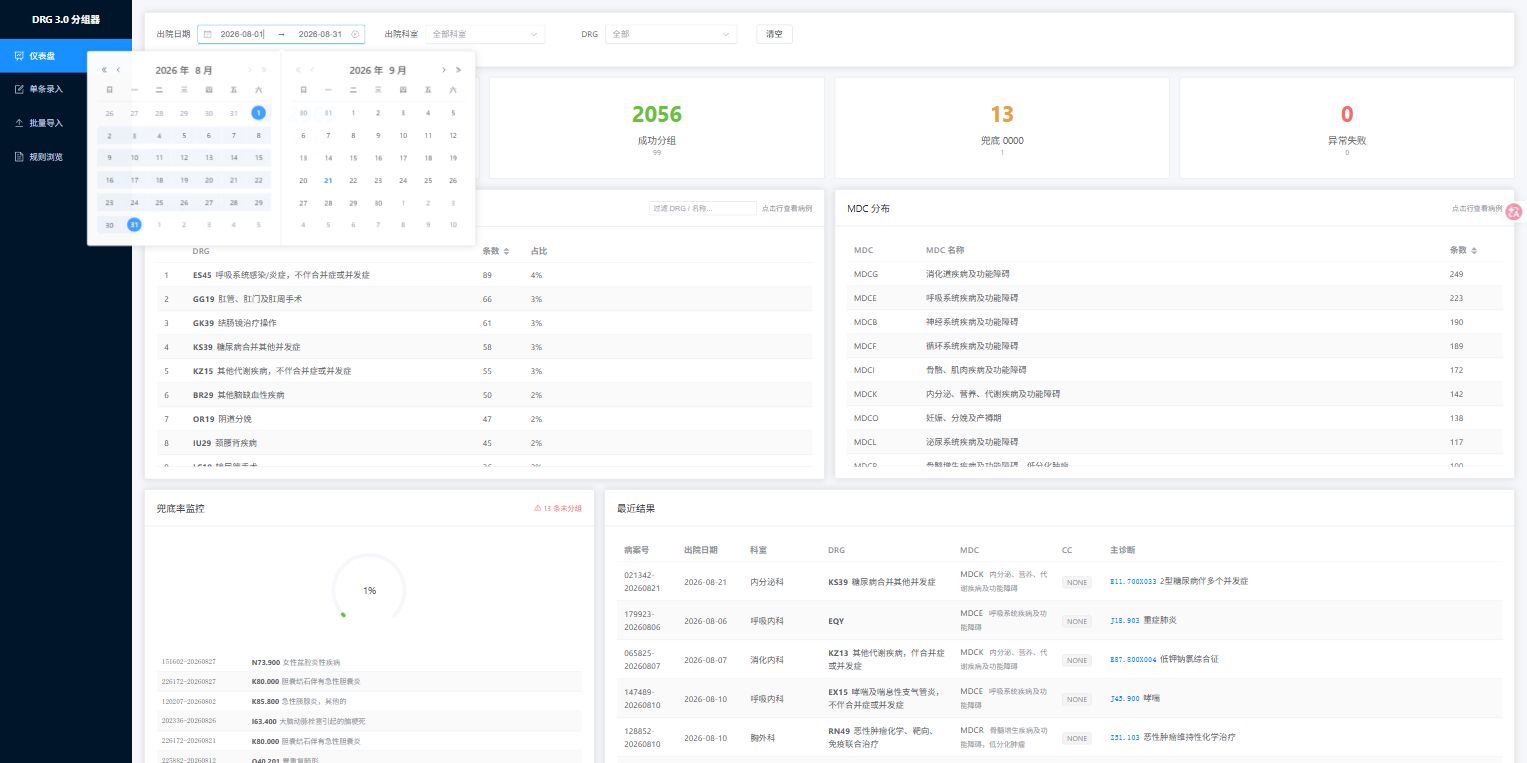
图 5:仪表盘修复后(2026 年 8 月数据)——总病案 2069,成功分组 2056(99%),兜底 0000 仅 13 例(0.6%),异常失败 0。
重点:后面 §Part 4 会讲到,这个仪表盘最初显示的是总病案 12414、兜底 78、占比全部 0%——那是 silent bug 没修之前的”假象”。
Part 3 工程坑篇:7 个让人想骂街的坑,以及怎么爬出来
坑 1:xlsx 多行规则的反斜杠换行
症状:多发创伤(MDCZ)的 9 条 OR 规则,在 Excel 单元格里用 \ 续行:
1 | ((ZYZD in DI_Z01) and (QTZD in {DI_Z02, ...})) or \ |
openpyxl 读出来后,这 9 条会被读成 9 个 cell.value,我们必须自己拼接。
解决:预处理折叠
1 | def preprocess(rule_text: str) -> str: |
坑 2:恒真规则 “1”
症状:部分规则就是裸的 "1",啥意思都没有。
解决:归一化为 1 = 1,对应 ConstTrueNode AST 节点。不写特例代码——所有规则都走 AST 解释器,避免特殊情况特殊逻辑。
坑 3:集合字面量 {ZYSS, QTSS} vs 单变量 ZYZD
症状:有的 in 是单变量,有的要查多个变量的并集。
解决:语法层显式分支
1 | in_check := '{' IDENT (',' IDENT)* '}' KW_IN IDENT # 集合字面量 |
单测覆盖:集合字面量”任一命中”、”都不命中”两种场景。
坑 4:CC 排除逻辑——最容易写错的地方
症状:CC(MCC/CC)分级的本质是”主诊断和次诊断不能在同一系统”。
正确算法:
1 | def classify_cc(case, index): |
坑:
- MCC 优先于 CC(先找 MCC,没找到才找 CC)
- 一个诊断可能对应多个 EX_n,遍历时任一与主诊断不同就算命中
- QTZD 为空直接 NONE,不抛错
狼叔专门写了 4 个回归用例(同系统排除、跨系统 MCC、空 QTZD、主诊断未命中 EX),这个 CC 模块是全项目 bug 率最高的。
坑 5:诊断编码大小写与空格
症状:HIS 来的数据有 " j12.100 "、"J12.100"、"J12.100 " 三种形态。
解决:
- 启动索引时:
code.strip().upper() - 录入时:前端表单预 trim
- 入库时:Case 入库前再 strip
三道防线,缺一不可。
坑 6:集合用 frozenset + 双索引
38,203 行集合成员用 dict[set_id, frozenset[code]] 存主索引,再加 dict[code, set[set_id]] 反索引(用于”某编码属于哪些集合”,证据链展示用)。
性能:集合判定 O(1),反查 O(k),单病案分组 < 5ms。
坑 7:SQLite WAL 模式 + ThreadPoolExecutor 批量处理
症状:批量导入 1 万份病案时,单线程 50 秒,并发 100 线程后反而更慢——SQLite 锁竞争。
解决:
- SQLite 开启
journal_mode=WAL+synchronous=NORMAL(并发读写不死锁) - ThreadPoolExecutor 用 4 个 worker(超过 SQLite 写入吞吐会成瓶颈)
- 进度写
batch_jobs表,前端 SSE 拉
实测:1 万份病案分组,从单线程 50 秒压到 18 秒。
Part 4 silent bug 篇:一个 _safe_deserialize 如何骗走 1467 条病案
4.1 故事的开始:8 月份的诡异数据
2026 年 9 月,狼叔打开仪表盘,筛选 8 月份数据:
病例数分布占比第 1 名:IC 29 多部位髋、肩、膝、肘和踝关节置换术(1467 例)
狼叔瞬间警觉:IC 29 在我们医院不可能排到第一。
IC 29 是”多部位关节置换术”——这种手术在骨科非常罕见,通常用于类风湿关节炎晚期、多关节毁损等极端情况。我们医院骨科年手术量 4000+,多部位关节置换一年撑死 20 例,1467 例等于把全院 1/3 的骨科病案都判到了 IC 29。
而且更诡异:这 1467 例都是”正常”分组结果,error_type 全是 success——不像兜底,不像异常,就是正常命中。
4.2 第一次调查:规则文件?数据?
狼叔的第一反应是检查规则文件:
1 | ADRG IC2 多部位关节置换术 |
这条规则用了 length() 函数——这是 3.0 新增的语法,我的 DSL parser 不支持。
那为什么不是兜底而是 success?
4.3 真相:silent fallback pattern
翻看 _safe_deserialize 函数:
1 | def _safe_deserialize(blob: str) -> object: |
症状:解析失败时,不抛错,不告警,直接返回一个恒真节点 ConstTrueNode。
后果:
- IC2 这条规则 parse 失败 → 返回
ConstTrueNode - 解释器求值
ConstTrueNode→ 永远 True - 任何骨科病案走到 ADRG 层,都会”命中” IC2
- 因为 IC2 是按 priority 排序的第几条,后面其他 ADRG 永远不会被尝试
结果:1467 份病案被这条”silent 恒真”规则骗到了 IC 29。
4.4 silent fallback:所有规则引擎的天敌
这是规则引擎设计里最经典的反模式——用静默的恒真兜底来掩盖解析失败。
它特别危险,因为:
- 不报错——所有监控指标都正常,error_type 全 success
- 不告警——日志里找不到任何痕迹
- 业务语义错乱——分组结果看上去合理(医疗编码格式正确),实际是”瞎分”
这种 bug 在商业 DRG 系统里也存在,只是厂商不会告诉你。
4.5 修复:三重防线
(1) 解析失败 = 显式 is_invalid 标记
1 | def _safe_deserialize(blob: str) -> tuple[object, bool]: |
加 is_invalid: bool 字段,让规则”知道自己坏了”。
(2) 漏斗遇到 invalid 规则 = 跳过 + 记录证据
1 | # pipeline.py |
绝不 silent 跳过——必须记录到证据链,前端能看到”这条规则被跳过了,因为 DSL 不支持”。
(3) 扩展 DSL 支持 length() 和 ∩
IC2 那条规则是有意义的(length(OP_IC2 ∩ {ZYSS, QTSS})>=2),不能因为 parser 不支持就让规则死掉。
加 LengthCompareNode AST 节点:
1 |
|
加 KW_LENGTH 和 INTERSECT Token:
1 | # lexer.py |
加 _eval_length() 解释器:
1 | def _eval_length(node, case, ctx, ev): |
三层防御:
- 不让 bug 发生——DSL 支持所有合法规则
- 不让 bug 静默——
is_invalid+ 证据链记录 - 不让 bug 掩盖业务——分组失败兜底 0000,error_type = fallback
4.6 善后:重跑 8 月份病案 + 数据修正
修了引擎后,写了 scripts/regroup_aug.py 重跑 8 月份所有病案:
1 | python scripts/regroup_aug.py --month 2026-08 |
输出日志:
1 | INFO: 出院的 2026-08 病案共 2069 条,开始重跑 |
前后对比:
| 指标 | 修复前 | 修复后 |
|---|---|---|
| 总病案数 | 2069 | 2069 |
| 成功分组 | 2056 | 2056 |
| 兜底 0000 | 13 | 13 |
| IC 29 多部位关节置换术 | 1467 | 0 |
| ES45 呼吸系统感染/炎症 | 89 | 89 |
| GG19 肛管手术 | 66 | 66 |
IC 29 从 1467 → 0,DRG 分布恢复正常。
注意:历史 sync 的”假 IC 29”记录保留(审计用),但前端的 stats / list 都按 result_id MAX 取最新——所以仪表盘上立刻看到正确数据,不需要清理历史。
4.7 第二个 silent bug:Dashboard 占比 0%
修了 IC 29 之后,狼叔打开仪表盘发现:
总病案数 12414,兜底 78,DRG 分布占比每一行都是 0%。
![早期 bug 现场:Dashboard 占比 0%]
原因有两个:
(1) 总病案数虚高
stats 接口没有去重——同一份病案被多次 sync 后,每次都生成一行 case_results,而 stats 直接 COUNT(*),把历史也算进去了。
修复:
1 | def _latest_result_subquery(session): |
每个 case_id 只取最新一条结果。
(2) 占比分子错
前端代码:
1 | {{ pct(row.count, total) }}% // ❌ total 是 stats 接口的 total,跟当前筛选一致 |
但 total 在 loadDistribution() 重新调用时,跟当前 filter 可能不一致。
修复:
1 | const totalCount = ref(0) // 当前筛选下的总病案数 |
修完后:总病案 2069,占比 4%/3%/3%/3%/3% 正常显示。
4.8 silent fallback 的工程哲学
这一系列 bug 给狼叔上了深刻的一课:
任何”为了不报错而做的兜底”都是定时炸弹。
工程里有三类兜底:
- 业务兜底——找不到就分到 “0000”——这是规则,有文档
- 工程兜底——异常就降级到默认值——这是反模式,危险
- silent 兜底——解析失败就当恒真——这是致命错误
狼叔现在的设计原则:
1 | if error: |
让失败可见,比让代码”永远成功”重要 1000 倍。
Part 5 安全篇:HIS 数据库的三层防线
5.1 问题的根源:HIS 是别人的
DRG 分组器要从 HIS 拉数据,但 HIS 不是我们管的——它是医院信息科维护的、可能用 SQL Server 2008、可能跑在内网、可能没有备份。
最危险的事:UPDATE cases SET ... 或 DELETE FROM cases WHERE ... 一不小心打到 HIS 库,轻则医保拒付,重则医疗事故。
5.2 三层防线
(1) 账号级:db_datareader
HIS 同步账号只授予 db_datareader 角色,任何 DDL/DML 都会被 SQL Server 直接拒绝——就算代码写错,数据库也不会执行。
1 | CREATE LOGIN drg_sync WITH PASSWORD = '...'; |
(2) 连接级:READ UNCOMMITTED + ARITHABORT ON
pyodbc 默认 autocommit=True,这意味着 SET 选项不会跨语句保留。但聚合查询里 CASE 在并发下可能抛 1934 错误。
1 | conn = pyodbc.connect(conn_str, autocommit=True) |
(3) 代码级:SQL 关键字黑名单
sync 脚本里所有 SQL 字符串在执行前,过一遍关键字检查:
1 | FORBIDDEN = ["INSERT", "UPDATE", "DELETE", "DROP", "TRUNCATE", |
即使前两层都失效,代码级也兜得住——任何带 UPDATE/DELETE 的 SQL 会在执行前直接抛错。
5.3 SQL Server 2008 兼容
HIS 还在跑 SQL Server 2008/2008 R2(别问为啥不升级),所以不能用:
| 函数 | 替代方案 |
|---|---|
STRING_AGG |
string.Join + Query 或 FOR XML PATH |
CONCAT |
ISNULL(a, '') + ISNULL(b, '') |
FORMAT |
CONVERT(VARCHAR, ...) |
TRY_CAST |
自行写异常处理 |
TRY_PARSE |
自行写异常处理 |
狼叔在 scripts/his_sync.py 里把这些替代模式封装成 helper 函数,避免每个 SQL 都重写一遍。
5.4 HIS 字段的特殊处理
FAGE(年龄)字段可能是 'Y74'、'74岁'、74 三种格式,必须先 normalize:
1 | def parse_fage(raw) -> int | None: |
FSEX(性别)是 '男'/'女',normalize 成 1/2:
1 | def parse_fsex(raw) -> int | None: |
这些 dirty data 字段,任何一处 normalize 漏了,都会让 10-30% 的病案年龄/性别错。
Part 6 数据篇:8 月份的真实运行结果
6.1 整体情况
2026 年 8 月份(修复后),全院出院病案:
- 总病案数:2069
- 成功分组:2056(99.4%)
- 兜底 0000:13(0.6%)
- 异常失败:0
兜底率 0.6%,远低于 5% 的健康线,说明:
- 编码质量高(主要诊断 + 主要手术 90%+ 完整)
- 引擎覆盖了绝大多数场景
- 编码映射(HIS 国临版 → 医保版)准确
6.2 DRG 分布 Top 10
| 排名 | DRG | 名称 | 例数 | 占比 |
|---|---|---|---|---|
| 1 | ES45 | 呼吸系统感染/炎症,不伴合并症或并发症 | 89 | 4% |
| 2 | GG19 | 肛管、肛门及肛周手术 | 66 | 3% |
| 3 | GK39 | 结肠镜治疗操作 | 61 | 3% |
| 4 | KS39 | 糖尿病合并其他并发症 | 58 | 3% |
| 5 | KZ15 | 其他代谢疾病,不伴合并症或并发症 | 55 | 3% |
| 6 | BR29 | 其他脑缺血性疾病 | 50 | 2% |
| 7 | OR19 | 阴道分娩 | 47 | 2% |
| 8 | IU29 | 颈腰背疾病 | 45 | 2% |
| 9 | LC19 | 输尿管手术 | 36 | 2% |
| 10 | XT19 | 其他后期照护 | 33 | 2% |
前 5 占比合计 16%,分布健康——如果某 DRG 占比 > 20%,大概率有 bug(比如 IC 29 那种 silent 命中)。
6.3 兜底病例分析
13 例兜底,主要集中在:
- 新生儿科(3 例):早产儿+多系统并发症,3.0 新生儿规则没覆盖
- 肿瘤科(4 例):复杂联合化疗,DRG 子组缺失
- 精神科(2 例):合并躯体疾病,跨 MDC
- 其他(4 例):编码错误或缺失
这些都是已知 limitation,已提交给医保局作为下一版规则修订建议。
Part 7 反思篇:8 个教训,送给所有想自建规则引擎的人
教训 1:规则引擎的核心是”能解释”,不是”能跑”
商业 DRG 系统把规则藏在代码里,你只能信它。自建引擎最大的价值是:任何一条分组结果,你都能解释到 xlsx 的某一行某一条规则。
教训 2:DSL 是规则的”载体”,不是规则的”装饰”
医保版的规则是给医保局内部审计员看的,不是给程序员看的。DSL 设计要站在医保局审计员的视角:
- 关键字要贴近业务术语(
in/not in/length,不要contains/count) - 错误信息要精确到 xlsx 行号
- 集合名要直接用 xlsx 的列名(
DI_B00,不要DiseaseSetB00)
教训 3:证据链不是”日志”,是”产品”
很多团队把证据链当作”调试时用的日志”,上线后就关掉。错。证据链是申诉场景的核心交付物——医保局、医院科室、患者都可能质疑分组结果,必须能立即拉出证据。
教训 4:silent fallback = 慢性自杀
if error: return True 这种代码,写的时候很爽,debug 的时候想死。
让失败可见——加日志、加 is_invalid 标记、加证据链节点、加监控告警。让所有 silent 的地方都”响起来”。
教训 5:数据质量是”看不见的 80%”
规则引擎再准,数据质量差也是白搭:
- HIS 国临版编码 → 医保版编码,要建映射表
- 年龄字段
Y74/74岁/74三种格式,要 normalize - 出院科室要从 HIS 拉,映射到医保版的科室字典
- 主要手术字段经常是空的,要从其他手术里推断
狼叔估计,40% 的工作量在数据清洗,30% 在规则引擎,20% 在前端,10% 在其他。
教训 6:HIS 数据库访问是”危险边缘”
三层防线不是过度设计,是必要设计。任何一个 DRG 项目失败,80% 不是规则问题,是 HIS 访问出问题(误写、误删、数据漂移)。
教训 7:测试覆盖率不是 KPI,是”救命稻草”
CC 分级算法的那 4 个回归用例,救了狼叔 3 次。每改一次规则文件,狼叔都先跑一遍:
tests/test_parser.py:11 个 parser 用例tests/test_cc.py:4 个 CC 分级用例tests/test_pipeline.py:3 个端到端用例
如果测试覆盖不到,改完代码根本不敢上线。
教训 8:医保改革是”长期战”,不是”一次性项目”
3.0 不是终点,是过程中的一个版本。医保局每年都会调整规则,DRG 项目必须设计成”可演进”:
- 规则文件升级:换一份 xlsx + 重启服务(30 分钟)
- 集合扩充:加几行 set_members(几秒钟)
- 新 DRG 子组:加一行 drg_rules(几分钟)
如果每次升级都要改代码、改数据库、重新培训——这个项目就废了。
后记:一个骨科医生为什么要写 5400 行代码
狼叔不是程序员,狼叔是医生。
写这个项目的初衷,不是为了”炫技”,也不是为了”评职称”,而是因为狼叔相信一件事:
医疗数据的所有权,不应该在厂商手里,应该在医院手里。
商业 DRG 系统按例收费、按版本收费、按培训收费——医院永远是被动的。我们买的是”使用权”,不是”所有权”。
自建 DRG 引擎,把规则、引擎、数据、证据链全部掌握在自己手里,医院才有真正的”数据主权”。
代码是开源的(项目地址:[GitHub 链接]),规则文件是医保局公开的,引擎是 5400 行 Python——任何一位会 Python 的医院信息人,都能在 3 个月内复刻出来。
狼叔希望更多的医院,特别是地市级和县市级医院,能走这条路。
DRG 是医院的命脉,不应该由外人决定。
[!NOTE] 项目信息
项目地址:D:\Documents\Project\drg3 (本地)
代码量:约 5400 行 Python + 2200 行 Vue3
核心文件:
backend/app/engine/parser/— DSL lexer + parser + ASTbackend/app/engine/runtime/evaluator.py— 解释器backend/app/engine/grouper/pipeline.py— 三层漏斗backend/app/engine/grouper/cc.py— CC 分级backend/app/engine/index.py— 内存索引backend/scripts/his_sync.py— HIS 同步(只读,三层防护)frontend/src/views/Dashboard.vue— 仪表盘frontend/src/views/ResultDetail.vue— 证据链展示
技术栈:Python 3.11 + FastAPI + SQLAlchemy + SQLite (WAL) + Vue3 + Element Plus + Vite + Pinia
运行方式:uvicorn app.main:app --port 8000+npm run dev
致谢:感谢欧阳艾老师的《从 3.0 规则文件到 DRG 分组器》一文,启发了整个项目的基础架构;感谢医院信息科、医保办、病案室的所有同事,在数据接入、规则校验、case 复盘中的紧密配合。
狼叔,2026 年 9 月 21 日,完稿于办公室
 微信
 支付宝