质管办自研医院质管AI知识图谱实战——65 份制度 PDF、21455 个实体,以及我如何让机器读懂并回答"制度怎么说"| 器数维新
[!ABSTRACT] 核心摘要
项目:医院医疗质量管理知识图谱(65 份院内制度原文 → 可溯源、可对比、可问答的知识底座)
领域:医疗质量管理 · 知识图谱 · GraphRAG · 制度版本治理
核心指标:21455 个实体 / 91595 条关系 / 4699 个原文块 / 64 种受控谓词 / 10 个制度 16 组版本对比 / 问答 1.2 秒 4 路检索
三条主线:
- 构建篇——从 PDF 解析到建图,6 道流水线,每道都有让人想骂街的坑(表格被 OCR 吃掉、中文关系类型被拒、谓词判错一次就吃掉 2646 条关系)
- 建模篇——制度”两个版本”的差别不会自动出现在图上,必须单独建模;而且配对失败的条款只能叫”未配对”,不能叫”废止”
- 落地篇——网站只看、构建留本地:后端把 13 条管理接口物理不注册,敲 URL 也是 404
引子:一个临床科室的问题,和半小时的翻找
质管办最常接到的一类电话,大概是这样的:
“入院记录超过 24 小时没完成,医院到底怎么罚?”
我的回答通常是:你等等,我查一下。
然后去翻那 65 份制度文件。
65 份 PDF、303MB:2018 版和 2024 版《病历书写规范》、2021 版和 2024 版《临床路径实施方案》、五份不同年份的《国家医疗质量安全目标实施方案》、29 份核心制度、《不良事件管理办法》三个版本……
要回答”入院记录超时怎么罚”,我得先想清楚:
- 是找病历书写规范(里面有时限要求),还是找病历管理制度(里面有考核条款)?
- 2024 年 9 月刚刚修订过,那 2018 版的还算不算数?
- 处罚是”扣绩效”还是”扣款”?通报里是写了 25 块,但那是通报里的事,制度里的条款是另一套话。
半小时后答案出来了,内容是对的,但心里不太舒服。
不是因为答错了,是因为”答对”这件事本身太贵了。
我算过一笔账:质管办一年要回答多少次这种问题?每一次都是半小时,每一次都要在 300MB 的 PDF 里”大海捞针”——而且捞针的人必须已经知道针在哪一页,否则连捞的方向都没有。
于是我开始想一个有点”疯狂”的问题:
能不能让机器把这 65 份制度读成一张图?
不是让人去搜,而是让机器能回答”制度怎么说”,并且每一个答案都能点回原文那一页?
这一期《器数维新》,记录的就是这个”疯狂”决定的完整建造记。
从 2026 年夏天到 10 月,一整套官方语义库(semantica 0.7.0)流水线,从 PDF 解析到版本差异建模,从 GraphRAG 问答到内网服务器部署。
先看成果。
Part 1:成果长什么样
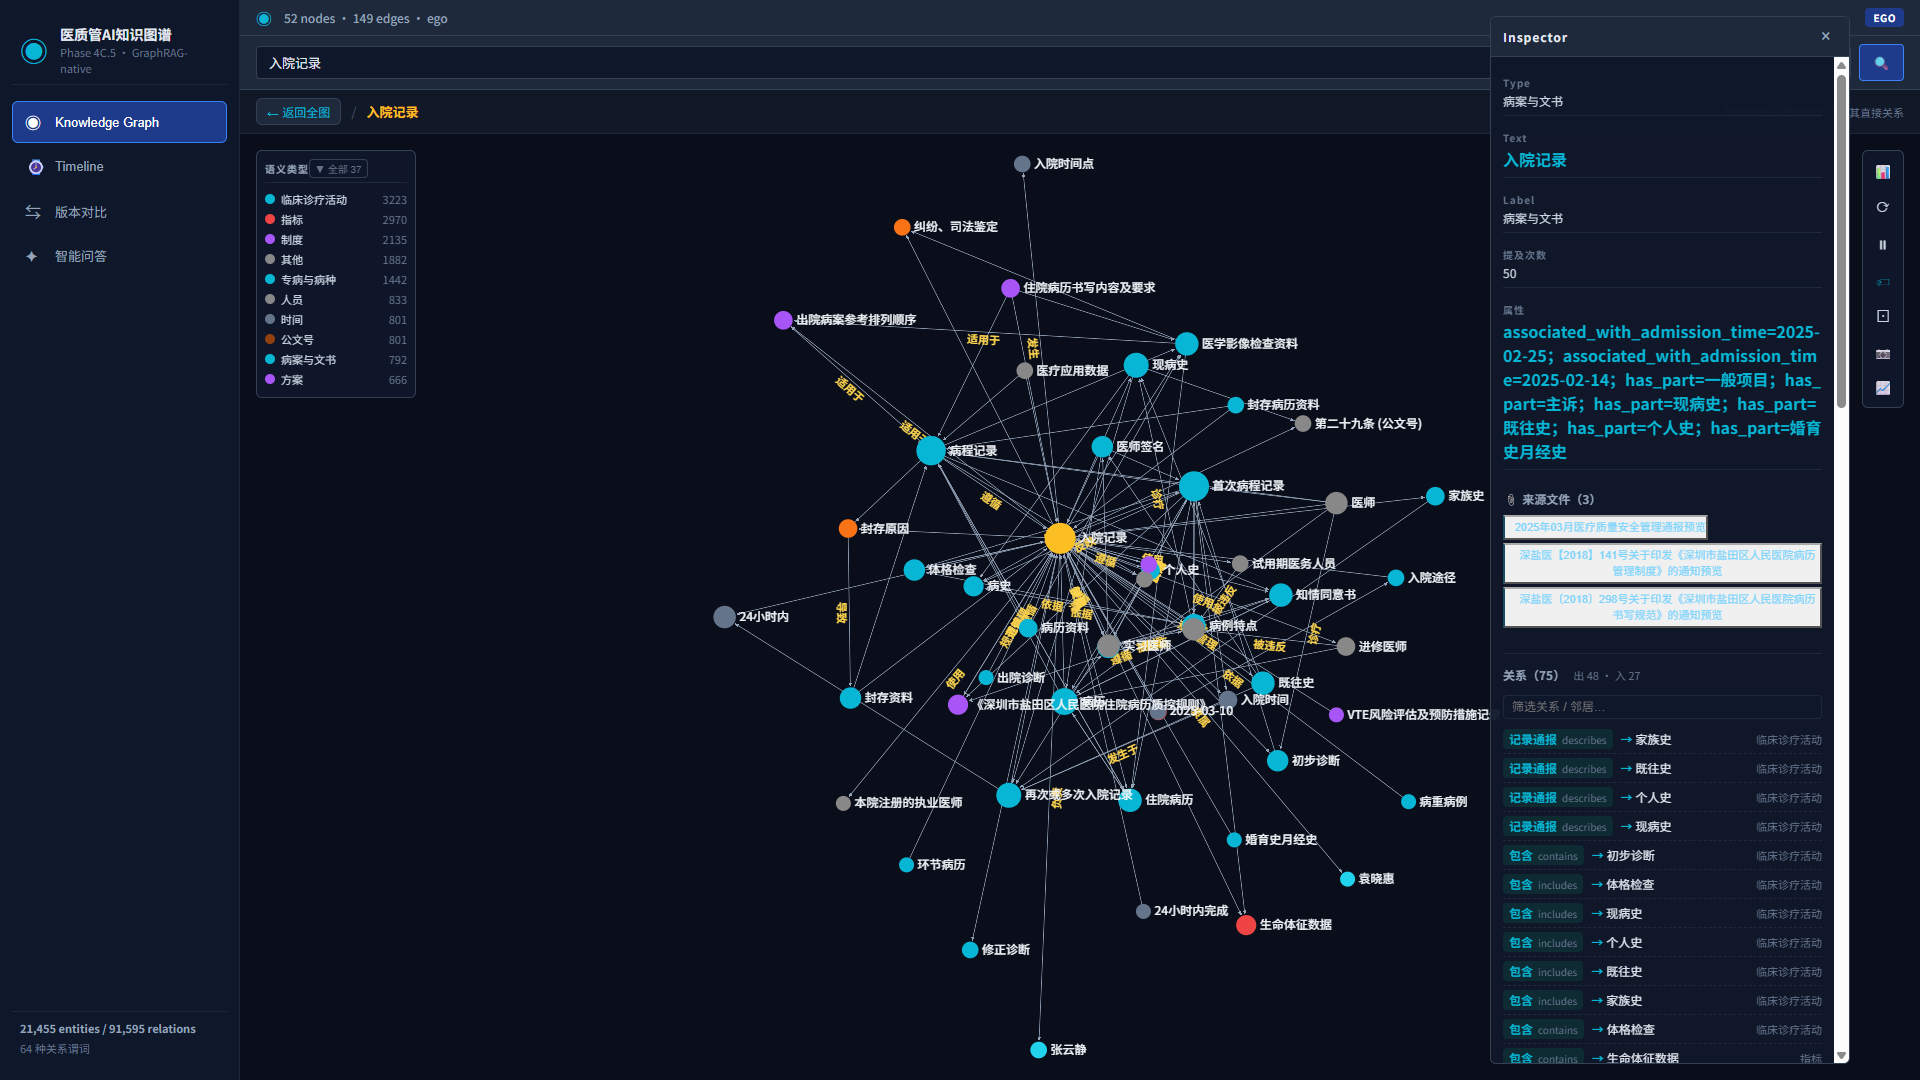
1.1 一张能点的图
上图是部署在内网服务器上的实机界面。搜索”入院记录”,图谱自动聚焦到它的 52 个邻居节点;右侧 Inspector 面板告诉你:
- 这个实体在病案与文书类目下,全院被提及 50 次
- 它有 3 个来源文件(2025 年 3 月的质量通报、2018 年病历管理制度、2018 年病历书写规范)
- 它连着 75 条关系(出 48 入 27):谁属于它、它包含谁、它和谁相关
右下角那三个蓝色的文件名,是可点击的。 点进去就是原件。
1.2 一个能溯源的答案
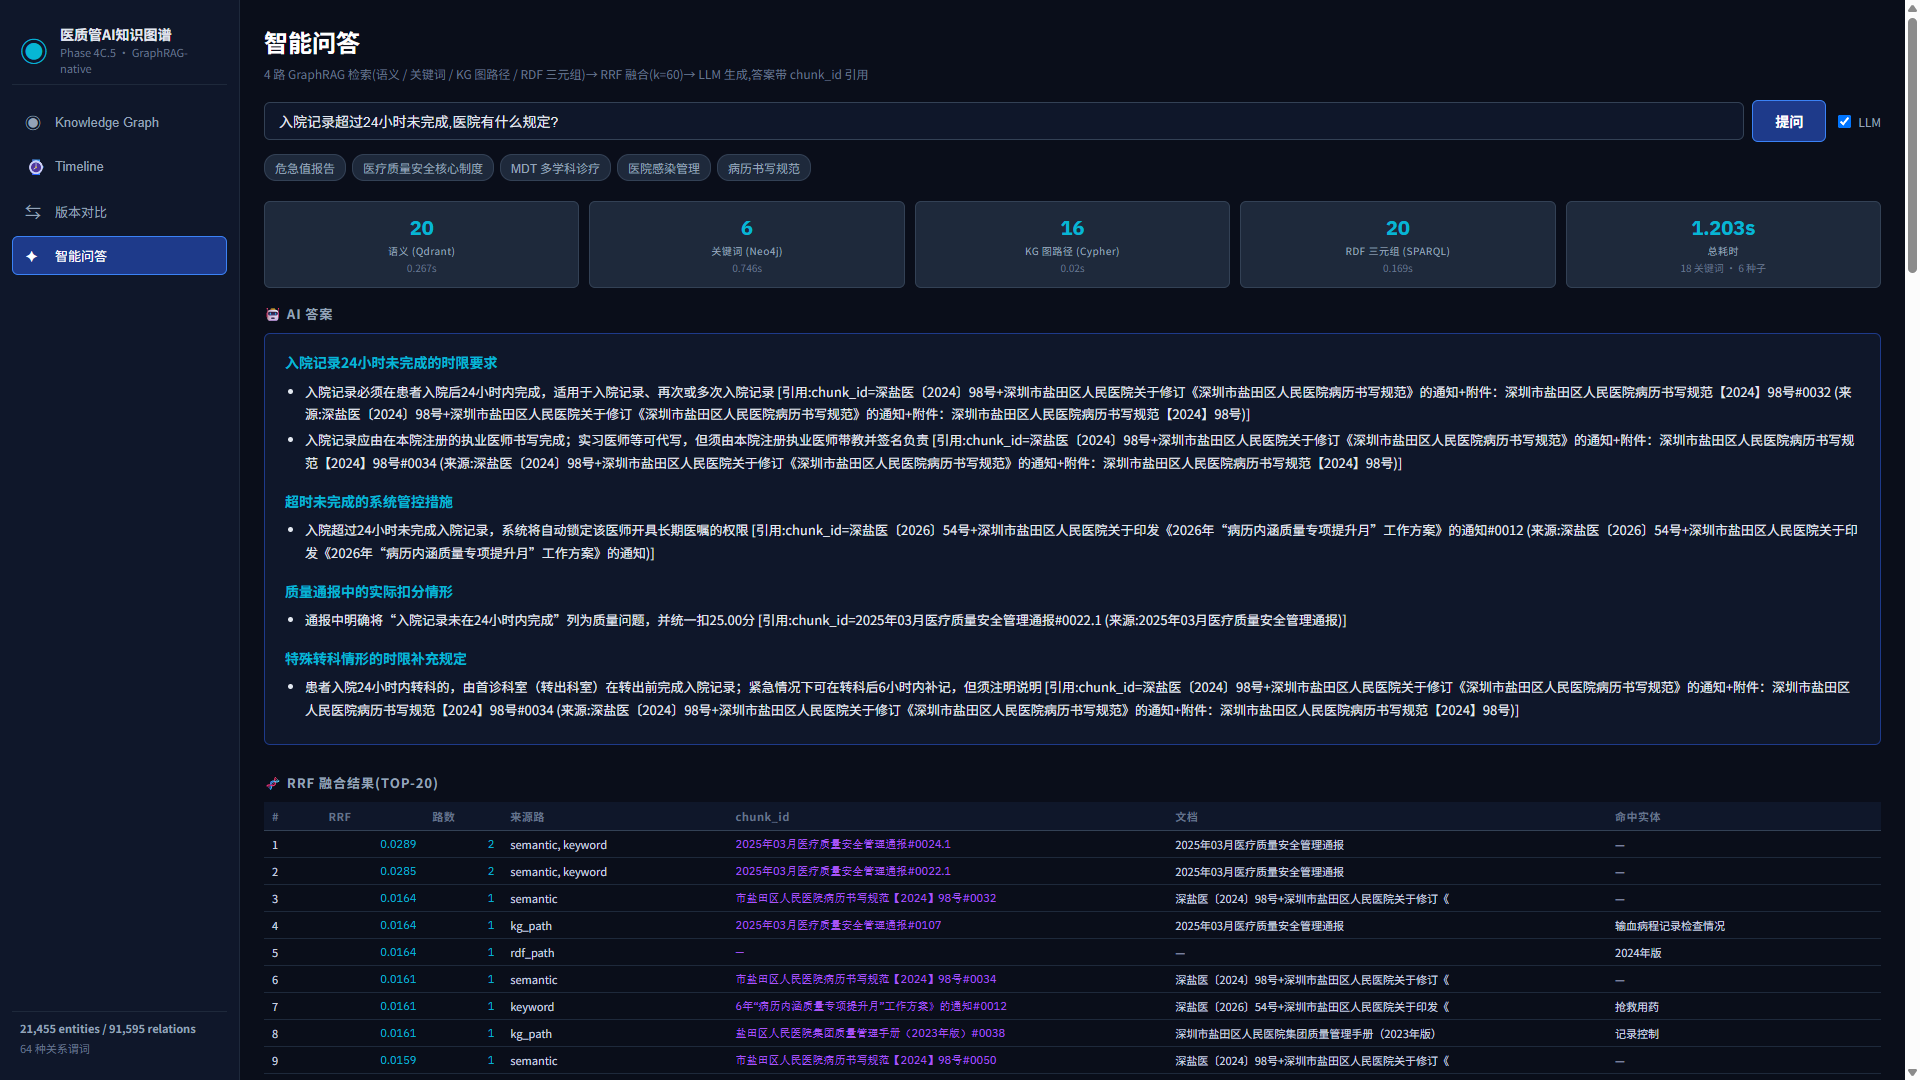
同一个问题,交给知识图谱:
1 | 入院记录超过24小时未完成,医院有什么规定? |
1.2 秒,四路检索同时跑(语义 20 条、关键词 6 条、图路径 16 条、RDF 20 条),RRF 融合后交给大模型生成,答案长这样:
入院记录24小时未完成的时限要求
- 入院记录必须在患者入院后24小时内完成,适用于入院记录、再次或多次入院记录 [引用:chunk_id=深盐医〔2024〕98号…病历书写规范【2024】98号#0032]
- 入院记录可由实习医师、试用期医务人员或进修医师书写,但须由本院注册执业医师审核签名;若24小时内转科,首诊科室须在转出前完成入院记录(紧急情况可6小时内补记并说明) [引用:…#0034]
超时未完成的系统管控措施
- 入院超过24小时未完成入院记录,系统将自动锁定该医师开具长期医嘱的权限 [引用:…2026”病历内涵质量专项提升月”工作方案#0012]
质量通报中的实际扣分情形
- 通报中明确将”入院记录未在24小时内完成”列为质量问题,并统一扣25.00元 [引用:2025年03月医疗质量安全管理通报#0022.1]
注意每一个结论后面的方括号。这是整个项目的灵魂:不是让模型”知道”,是让它”说得出来源”。质管办的答案如果不能点回原文,那它就是一个不能用的答案。
Part 2:为什么”翻制度”这件事,本来就该被机器接管
在做之前,我想先把问题定义清楚,否则很容易做成一个”更快的 PDF 全文检索”,那玩意儿满地都是,不值得做。
2.1 制度检索的三个死结
死结一:同一件事,散在不同文件里。
“入院记录超时”这件事:
- 《病历书写规范》里写的是时限要求(必须 24 小时内完成)
- 《病历管理制度》里写的是考核与扣罚
- 《医疗质量(安全)不良事件管理办法》里写的是如何上报
- 质量通报里写的是实际扣了多少钱
你问”医院怎么罚”,正确的答案是把这几处拼起来。全文检索给你的是四段孤立的文字,拼这一步仍然要人做。
死结二:文件有版本,而且版本之间体例完全不同。
这是最麻烦的一条。2018 版《病历书写规范》是”7 章 50 条”的传统公文;2024 版是”7 篇 53 节”的新体例,章节名全变了。
更要命的是:同名章节在两版里含义都变了。比如”(一)”这种编号,2018 版里是”款”,2024 版里是”节下面的子项”。用同一套规则切两版文件,切出来的东西根本不是一回事。
死结三:指标藏在表格里,而表格是 PDF 最难读的部分。
国家医疗质量安全目标方案里,每个目标都有一张表:目标简述、核心策略、改进措施、监测指标。全是表格。
而 PDF 里的表格,是所有解析器的噩梦。
我做过一个对照实验:同一份 263 页全是表格的文件,
| 官方 Docling | 换成表格专用解析 | |
|---|---|---|
| 提取字符数 | 24,430 | 223,503(9.1 倍) |
| 表格单元格数 | 0 | 27,618 |
| 断行率 | 92% | 0% |
9.1 倍的差距,不是调参调出来的,是”根本没读进去”和”读进去了”的区别。
2.2 所以目标不是”搜索”,是”回答 + 溯源”
我把目标写成了四条硬指标,后面每一步都拿它验收:
- 答案必须带原文出处,精确到哪个文件的哪一块(不是”第几页”,是 chunk_id)
- 版本差异必须能看见,并且只能叫”未配对”的地方绝不能叫”废止”
- 问错了要老实说不知道,不许编
- 能溯源到原件,点一下就看到那份 PDF 的那一页
第 2 条我会专门展开,因为它是整个项目里最容易骗到自己的地方。
Part 3:完整构建——六道流水线,每道都有坑
整个系统用官方 semantica 0.7.0 的流水线搭起来:解析 → 抽取 → 建图 → 推理 → 溯源 → 决策。
先说原则:能力一律用官方 API,不自己造轮子。官方确实没有的(比如版本差异比对、中间空格归一),自己写,并且在代码里显式标注”自研补充”,在文档里写清楚为什么官方没有。这条纪律听着像洁癖,实际上救命——下面会讲。
3.1 解析层:让机器先”看得懂”表格
我原本直接用官方 DoclingParser,很快发现两个必须解决的问题:
问题一:官方 Docling 遇到大文件会 OOM,而且永不返回。
表现是 std::bad_alloc 之后它反复重试同一批页,既不抛异常也不退出,还和主进程同生共死。我实测过一次一键重建卡死在同一批页上,只能强杀。
修法:把 Docling 调用隔离到子进程 + 超时(240 秒),崩了或超时直接放弃转 OCR 兜底。
页数阈值只能防大文件,防不住小文件偶发 OOM——所以隔离是必须的,阈值只是锦上添花。
问题二:官方 enable_ocr=True 对乱码 PDF 无效。
Docling 见文本层就不 OCR。而医院的扫描件 PDF 恰恰是”有文本层但是乱码”的。
于是我做了一件事:把 OCR 换成表格专用的解析器(MinerU),做三级降级:MinerU(主)→ 官方 Docling(兜底1)→ RapidOCR(兜底2)。
这里有三个实测出来的硬约束:
- 只能用 basic 档(纯 ONNX)。standard 档含本地 VLM,本机 2GB 显存跑不动,实测在文本层文件上直接段错误(退出码 3221225477,Layout Predict 40% 处崩)。
- ocr-mode 要按文件选:有表格或扫描件用
ocr,纯文本用txt(标点更准,但慢 2.6 倍)。 - 云端补强:basic 档的表格模型在”≥5 列 + 跨行 + 长段落”时会列错位,实测有一页的★否决项列内容直接丢失。这种页我丢给云端表格解析重跑(¥0.003/页),实测补强后 6 列对齐、否决项 5 条完整。
最后一步是表格必须用代码块围栏包起来。这是整条流水线里最反直觉但最关键的一个细节,下一节展开。
3.2 分块层:官方分块器的”真实机制”,和它教我的事
我用官方 StructuralChunker 切块。后来我读了一遍它的源码,发现它的工作方式和我想象的完全不一样:
| 结构元素 | 源码怎么拼 | 后果 |
|---|---|---|
paragraph |
" ".join(para_lines) |
行被空格压平 |
code_block |
"\n".join(code_lines) |
行结构保留 |
heading / list |
单独成块 | 正常 |
而且它绝不切开单个元素——超了就形成一个超限块。
两条推论,直接决定了我后面两个设计:
推论一:输入文本必须有结构。
我用 OCR 出的”每行一句”碎片喂进去,结果 5496 个字被压成一个巨块。条款埋在块尾,向量化时按前 2000 字截断——那条条款根本没进向量库。于是问答就是一句”证据不足”,而且我查了很久都不知道为什么。
换成带标题层级的 markdown 之后,同样的文件切出 934 块、平均 401 字、只有 18 个超限。
推论二:表格必须走代码块通道。
管道表格的每一行都不匹配任何结构规则 → 全被当 paragraph 压成一行 → 列关系直接丢失,实测出现一个 17312 字的表格块。
解法很土但有效:在解析阶段用 ``` 围栏把表格包起来。这是用官方 markdown 语法告诉分块器”这是结构化数据,别重排”。
这两个坑让我明白了一件事:用官方 API 不等于不用理解它。你得知道它的切分逻辑,才知道怎么喂它。
3.3 抽取层:大块喂模型,细块喂向量
抽取用的是官方 NERExtractor + RelationExtractor(LLM 模式)。
这里有个绕不过去的矛盾:
- 只用大块(分块器合并后的原始块):OCR 文本没有标题层级 → 巨块 → embedding 截前 2000 字 → 条款进不去向量库 → 问答召回不到
- 只用细块(≤1500 字切片):LLM 对每片独立抽取 → 跨片关系丢失。我实测过:原始谓词
exhibits_quality_issue直接消失了,依赖它的官方推理规则”患者质量问题责任人”整条失效,决策页是空的
所以必须分两层:
大块喂 LLM 抽取,细块喂
:Chunk节点 / 向量 / 引用。
并且检索粒度、向量粒度、引用粒度必须一致——source_chunks和关系的chunk_id都指向细块。
还有个缓存上的教训:抽取缓存我最初按 chunk_id 命名,结果一改切分规则,块序号全局错位,缓存全失效,149 个块重抽了 25 分钟。改成两层:模板层按内容哈希存(与 id 无关),每块一个文件存 slices。
★ 顺带说一句:LLM 抽出来的原始谓词名不稳定。同样一段文本两次抽取,exhibits_quality_issue 一次有、一次没有(qwen-plus 有温度)。所以我不把推理规则绑死在原始谓词名上,否则整套决策链路就是靠运气在跑。
3.4 谓词治理:一次判错,吃掉 2646 条关系
抽取出来的原始谓词是英文的自由短语(is_part_of、issued_by、violates……)。要变成图,得先映射成一套受控词表——我用 LLM 做这件事:输入 (原始谓词, 主实体类型, 客体类型) 三元组,输出 54 类受控中文谓词。
看着简单,实则是全项目最危险的一环。
因为有一条特殊规则:有些谓词是”属性式”的——它描述的是节点自己的属性,不是节点之间的关系。比如”入院时间是 2025-02-25”,这不该是一条边,应该是节点上的一个属性。
规则是这样运作的:
- 建图阶段(run_04):把属性式谓词的边转成节点属性 → 这些边不会进 Neo4j
- 谓词治理阶段(run_06):从 Neo4j 收三元组 → 所以它收不到属性式谓词
两条规则必须用同一份代码判断。否则:
我有一次把
is_part_of误判成了属性式。
结果:2646 条关系只剩下 25 条。整张图基本空了。
所以我把判定规则抽成一个独立文件,两个脚本都 import 它,任何时候只改一处。
★ 顺带记一个更隐蔽的坑:判定式谓词绝不能用 _of 后缀兜底。is_part_of / is_member_of / at_risk_of / increases_risk_of / associated_with_risk_of 全都是真关系,误判成属性 = 关系被吃掉,而且永远拿不到受控谓词。
3.5 建图层:官方库三个限制,每个都让我停工半天
图谱存 Neo4j(社区版 5.26.0)。踩了三个官方 API 的限制:
限制一:官方 create_relationship 拒绝中文关系类型。
1 | Invalid relationship type: '隶属'. Must start with a letter or underscore |
我的受控谓词全是中文 → 凡是建边都必须走 Cypher 字符串插值(配白名单校验防注入)。这不是 workaround,这是官方 API 的硬边界。
限制二:官方 get_relationships 返回的对象里没有 target 字段。
它返回 {id, type, start_node_id, end_node_id}。我一开始用 r.get("target") 取另一端,永远是 None → 迁边的时候一条都迁不过去(别名节点被删后,连 :Chunk 的入边一起丢,合并后变成孤点,检索再也命中不了)。必须按 start_node_id / end_node_id 判方向。
限制三:官方 create_nodes 是 CREATE 语义,不按 name 去重。
平时没事,但我磁盘满过一次,官方批量创建超时重试——第一遍已经建成功,重试又建一遍——
结果:41932 个节点,20966 个名字各两份。
后来我在建图前后都加了”删同名 + 查重名清影子”,才算稳住。
还有一个不算限制但很坑的:官方 get_nodes 有缓存。改完图再查同一个条件,可能返回旧数据(我 merge 完一个实体去查,别名还显示”还在”;换个名字查,0 条)。验证图状态前得换个条件查,或者直接用原生 driver 复核。
3.6 版本差异建模:整个项目里最容易骗到自己的一块
这块单独拎出来讲,因为它承担了质管办最核心的一项职能:新旧制度到底改了什么。
而且这一块,我犯了一个特别危险的错。
(1) 先说结论:版本信息不会自动出现在图上
我以为把两版制度都抽成实体、建成图,两版的差异自然就显出来了。
天真了。
主图里只有实体和原文块。两版制度里同名同义的条款会被实体归一合并成一个节点——比如”入院记录应在 24 小时内完成”,2018 版和 2024 版各有一句,归一之后它们变成同一个节点的两条出处。
**版本信息就这么丢了。**而且丢得很隐蔽:图看着还挺完整,你不去数条款根本发现不了。
所以必须单独建一层::PolicyVersion(制度版本)和 :Clause(条款),把版本当成一等公民建模。
(2)「替代」关系不能编
新版通知里通常有一句”原〈文号〉…即日作废”。这是替代关系的唯一依据。
我用正则去认,认出来才建”替代”边。认不出来就不建。
实测:临床路径 2024 版通知只写了”做出修订,予以印发”,没有”原…号…即日作废” → 不建替代边,旧版状态写”已被2024年版修订”,绝不写”已废止”。
这不是谨慎过度。质管办拿着”已废止”三个字去回复临床科室,是要出事的。
(3) 两版体例不同 → 先摊平到”款”级
前面说过:2018 版是”7 章 50 条”,2024 版是”7 篇 53 节”。章节名全变了,编号含义也变了。
直接条款级一对一配对,必然错。
我的做法是摊平:
- 2018 版:50 条 → 摊平成 454 个”款”
- 2024 版:53 节 → 摊平成 486 个”款”
- 每个款还要再拆成
(小标题句, 正文)—— 因为 2018 把小标题和正文写在一行,2024 拆成”节 + 款”,不拆这层配不上对
(4) 关键一层:章节级对齐(标题优先)
配对失败的条款,不能直接判”新增”或”废止”。要先看它的父章节在新版里还在不在:
- 父章节还在 → 说明只是被重排/拆并了 → 判**”改写”**
- 父章节没了 → 才判”废止/新增”
**没这一层就是错误结论。**实测:2018 版「住院病案首页书写规范及要求」下面的 83 个款,被误判成”废止”——
实际情况是:2024 版把它挪去了《住院病案首页填写规范指南》,一个字都没删。
质管办看到这个”83 条废止”,第一反应会是”我们哪年废过 83 条规定”。
(5) 算不动的问题
454 × 486 ≈ 22 万对。官方自带的 Jaro-Winkler 相似度是纯 Python 的 O(n·m),全量跑不动。
解法是便宜的召回 + 贵的打分:
- 字符 3-gram 倒排索引 + Jaccard,召回 top-8 候选(这一步是自研补充,已在代码里标注)
- 对候选调官方
calculate_similarity打分(这一步用官方 API)
(6) 三个”不许编”的细节
① 指标变更必须单独检测。
「病种 250 种 → 336 种」,字面相似度只有 0.83,按常规阈值就是”微调”。但这恰恰是质管办最该盯的那条。
所以我单独做了数值集合比对 → 单独标”指标变更”。而且只认有指标味的数字:带单位的、带小数的;裸整数不算(列表编号 “1.”、年份 “2022”、条款号全是噪声)。另外 ICD 编码要排除(“剖宫产手术 ICD-9-CM-3 编码:74.0,74.1…”里的数字不是指标)。
② 配对失败只能叫”未配对”,不能叫”废止”。
配对失败有两种可能:① 真的删了 ② 改写后没配上。直接标”废止”是编造结论。
实测这一项一度虚报到 418 条,改称”未配对”后才诚实。
③ 配对参数不能随便放宽。
我试过把召回放宽(top_k 8→20、接受阈值 0.55→0.40):
| 放宽前 | 放宽后 | |
|---|---|---|
| 配对总数 | 110 | 128 |
| 其中”未变”(相似度 ≥0.97)这种高质量配对 | 55 | 55 |
放宽只增加低质量配对,一条高质量的都没多——只会造出假的”修改”结论。保持 top_k=8 / accept=0.55。
(7) 有些组根本不可比,要敢拆
比对我坚持另一条:不可比的组,宁可不做,也不能硬配。
实测两例:
- 手术分级 2022→2024(2024 那份其实是”相关制度汇编”66 页)→ 款级配对率 1% → 整组去掉
- 临床用血 2020”流程” vs 2023”审核制度” → 章节级对齐 0 对 → 整条链拆掉
硬配的结果是”全是新增”——这种结论拿去汇报,是会误导决策的。
同理,整份都是管道表格的文件做不了条款级对比(切分器靠”一、/(一)/第X条”这类层级标记还原章节,纯表格切出 0 章节)。这类文件我显式跳过,只作为独立文件入库,供问答使用(“××目标归谁负责”这类问题照样能答)。
(8) 成果
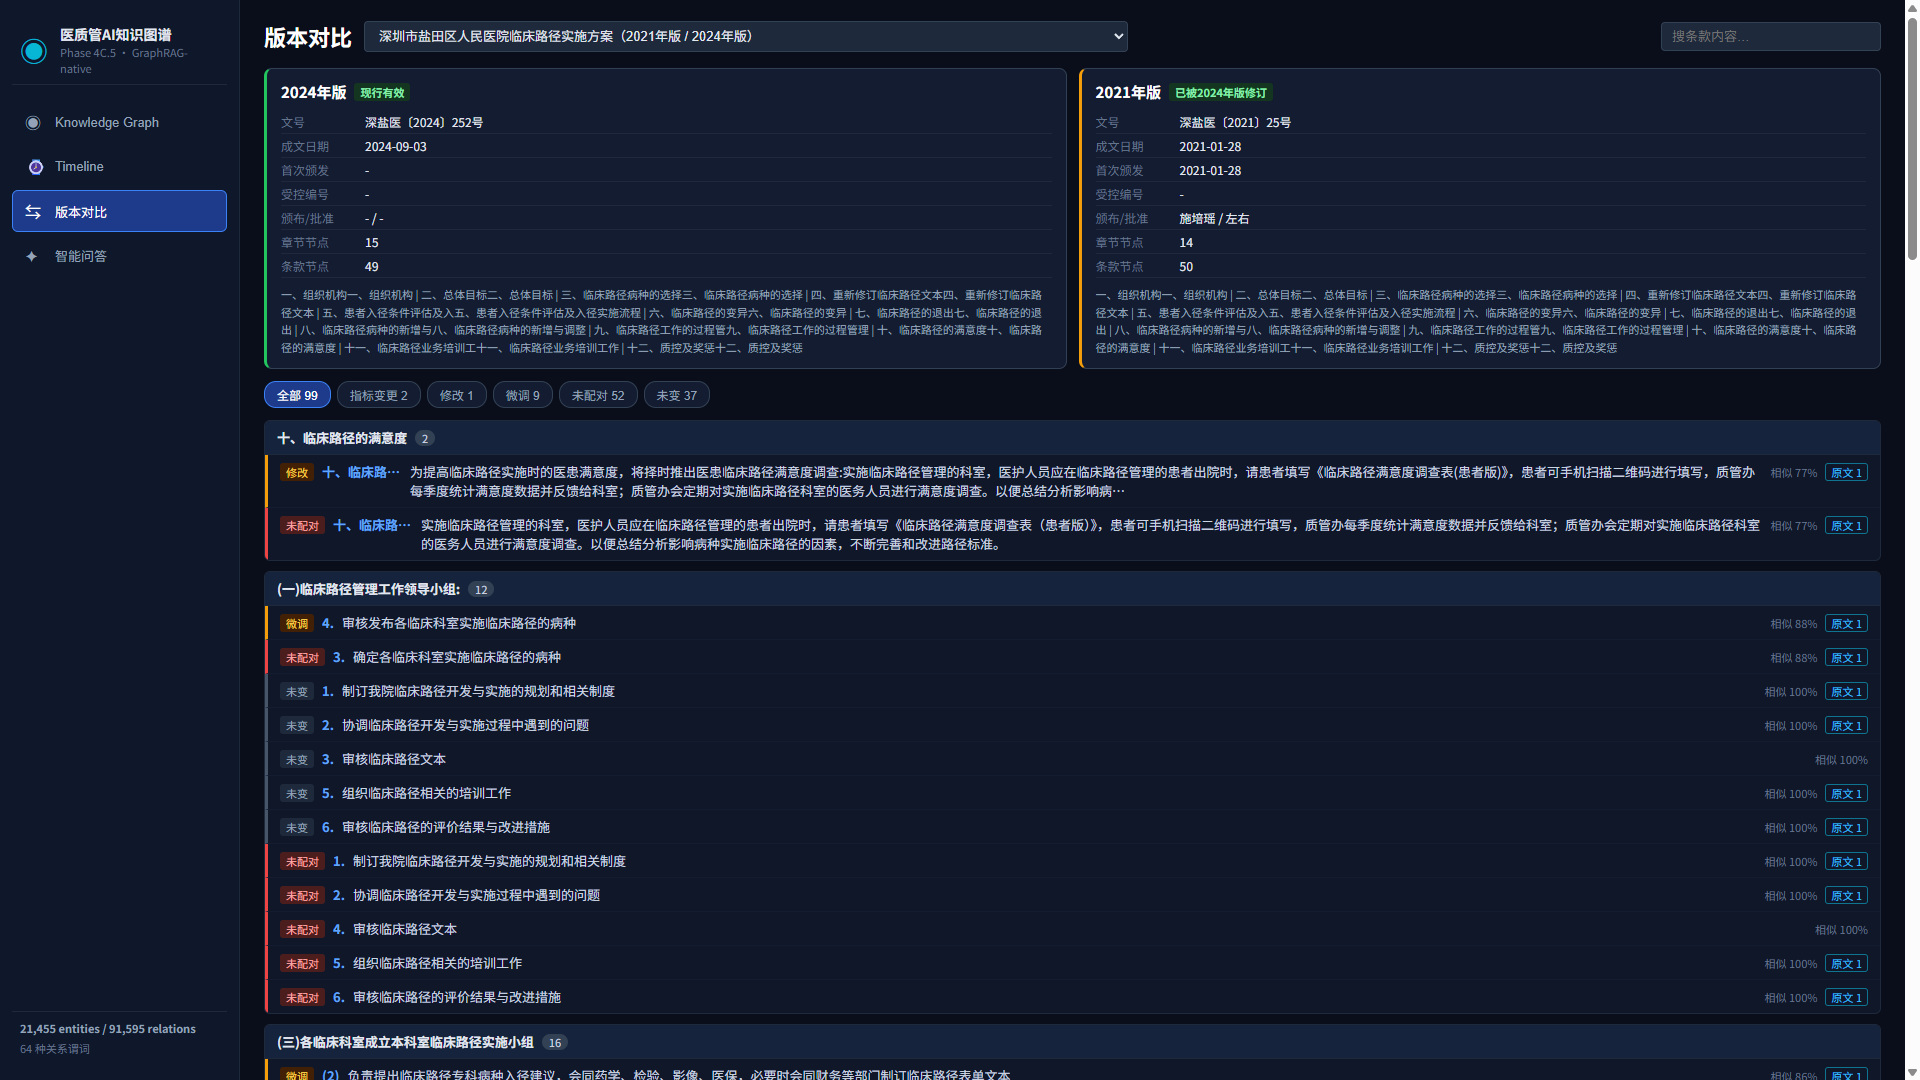
上图是《临床路径实施方案》2021 版 vs 2024 版的对比。左边 2024 版(现行有效,15 章节 / 49 条款),右边 2021 版(已被 2024 年版修订,14 章节 / 50 条款),下面是条款级差异清单:
- 每一行都有标签:修改 / 微调 / 未变 / 未配对 / 指标变更
- 每行都有相似度百分比
- 每行都能点”原文”跳到那一块
我特意把”未配对”这个标签做得很显眼(红色),而不是藏在”废止”这个词后面。 因为对一个质管办来说,”我不知道这两版对不上”是一个可以接受且诚实的信息,”这 52 条废止了”是一个会误导决策的信息。
现在总共做了 10 个制度、16 组对比:病历书写规范、临床路径、单病种、病历管理制度、手术分级、新技术准入、手术安全核查、抗菌药物、国家医疗质量安全目标(2021→2026 五版演进)、不良事件管理办法。
3.7 检索层:四路检索 + RRF 融合
最后是问答。质管办的问题形态很杂:有的问概念(“入院记录是什么”),有的问时限(“多久完成”),有的问责任(“谁负责”),有的问数值(“扣多少钱”)。
单一检索路覆盖不了,所以做了四路并行,再用 RRF(k=60)融合:
| 路 | 技术 | 擅长 | 实测命中 |
|---|---|---|---|
| 语义 | Qdrant 向量(DashScope qwen3.7-text-embedding-flash,1024 维) | 同义表达、模糊提问 | 20 |
| 关键词 | Neo4j Cypher 全文 | 精确术语、指标名 | 6 |
| 图路径 | Neo4j Cypher 图扩展 | 关系推理(谁→谁→什么) | 16 |
| RDF 三元组 | 官方 TripletStore(oxigraph) SPARQL | 语义层关系推理 | 20 |
四路任何一路失败都不影响其它路,失败信息在界面上直接可见(不静默吞掉)。
融合后取 TOP-20 交给大模型生成答案,prompt 里强制要求引用 chunk_id。上面 Part 1 那张截图里,每个结论后面的方括号就是这么来的。
Part 4:四个真正在用的场景
工具做完就吃灰,是所有信息化项目的通病。所以我关心的第一个问题是:这东西到底解决了我每天的哪个动作?
4.1 溯源到原文那一页
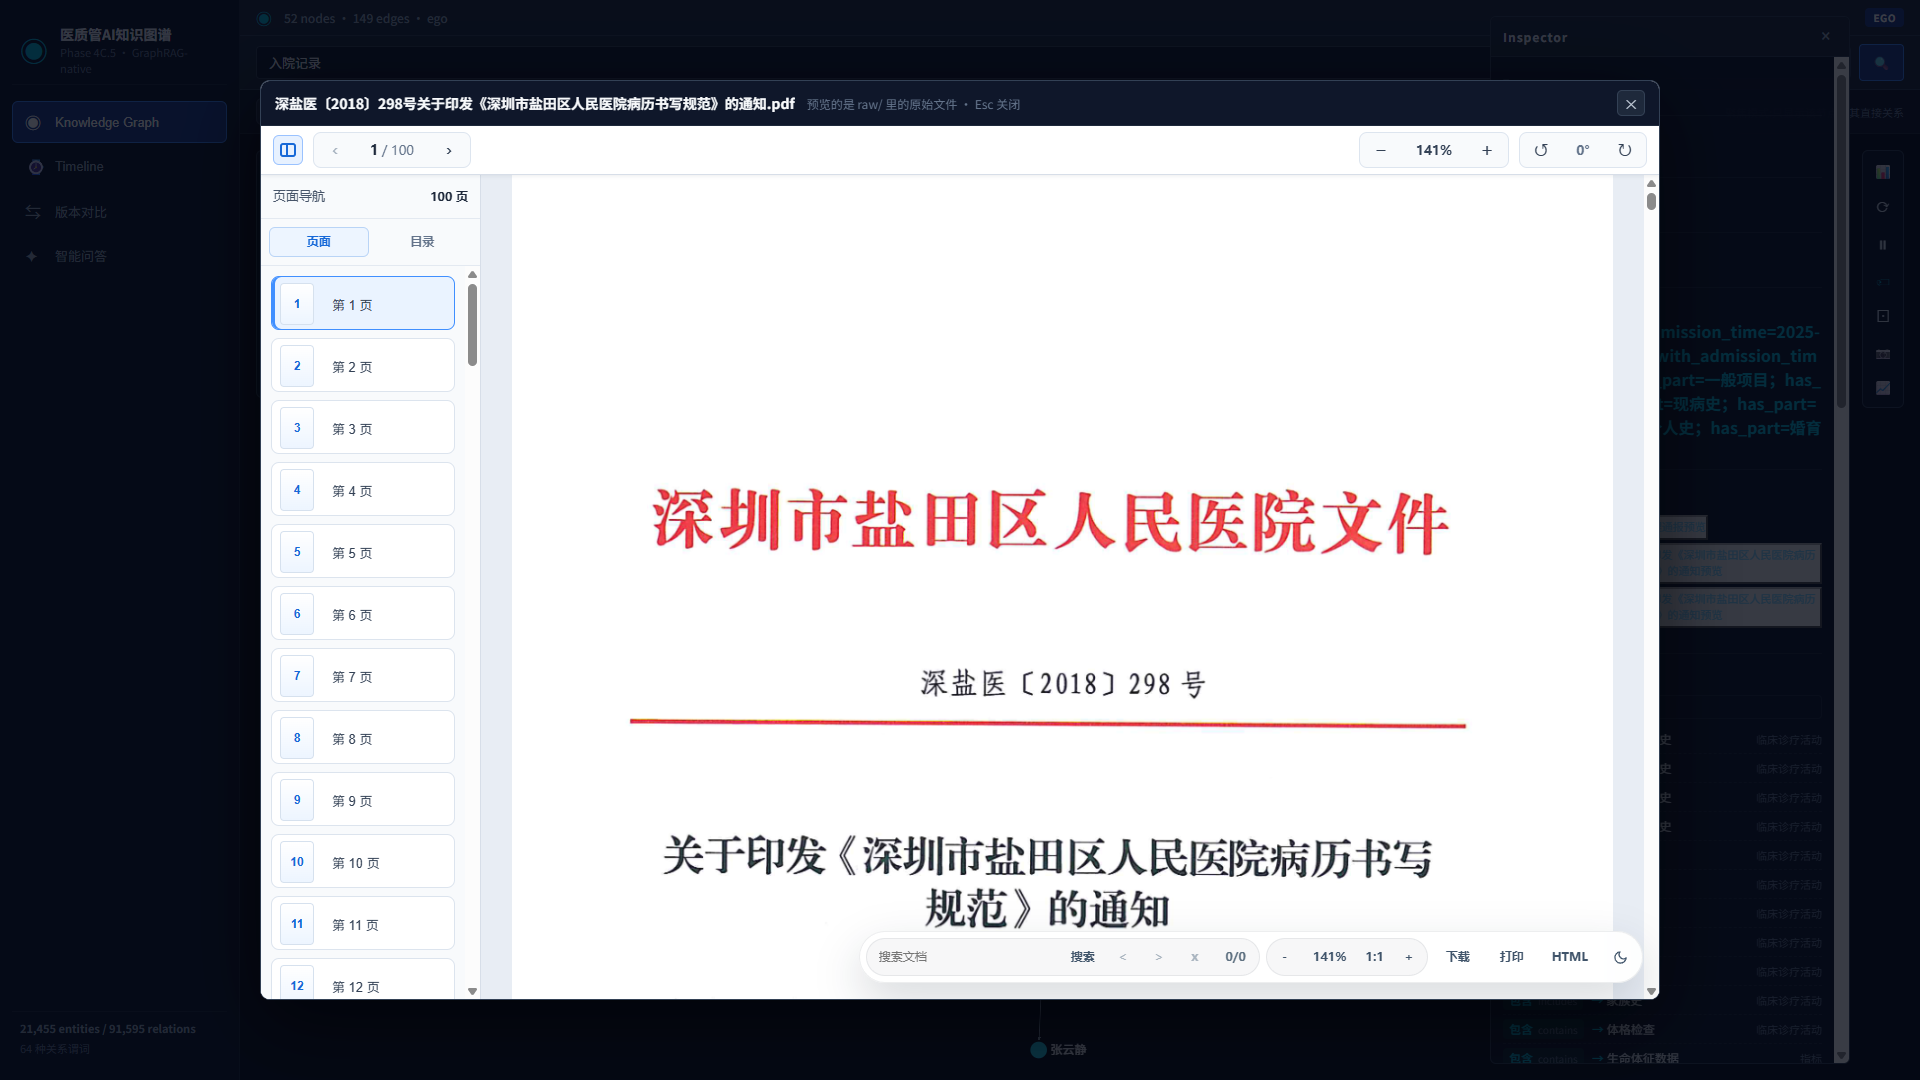
上面截图是点开”来源文件”后的原件预览——100 页的 2018 版《病历书写规范》,红头、文号、标题一字不差。
这一步的意义在于:以前我查制度,要在 PDF 里翻页找位置;现在从图谱上点到节点、点到来源文件,直接看到原文,而且能搜索、能打印、能下载。
顺带说一句,预览的响应头上有 Content-Range,说明支持分段取——42MB 的 PDF 不用一次性灌进浏览器。
4.2 时间轴:制度的”编年史”
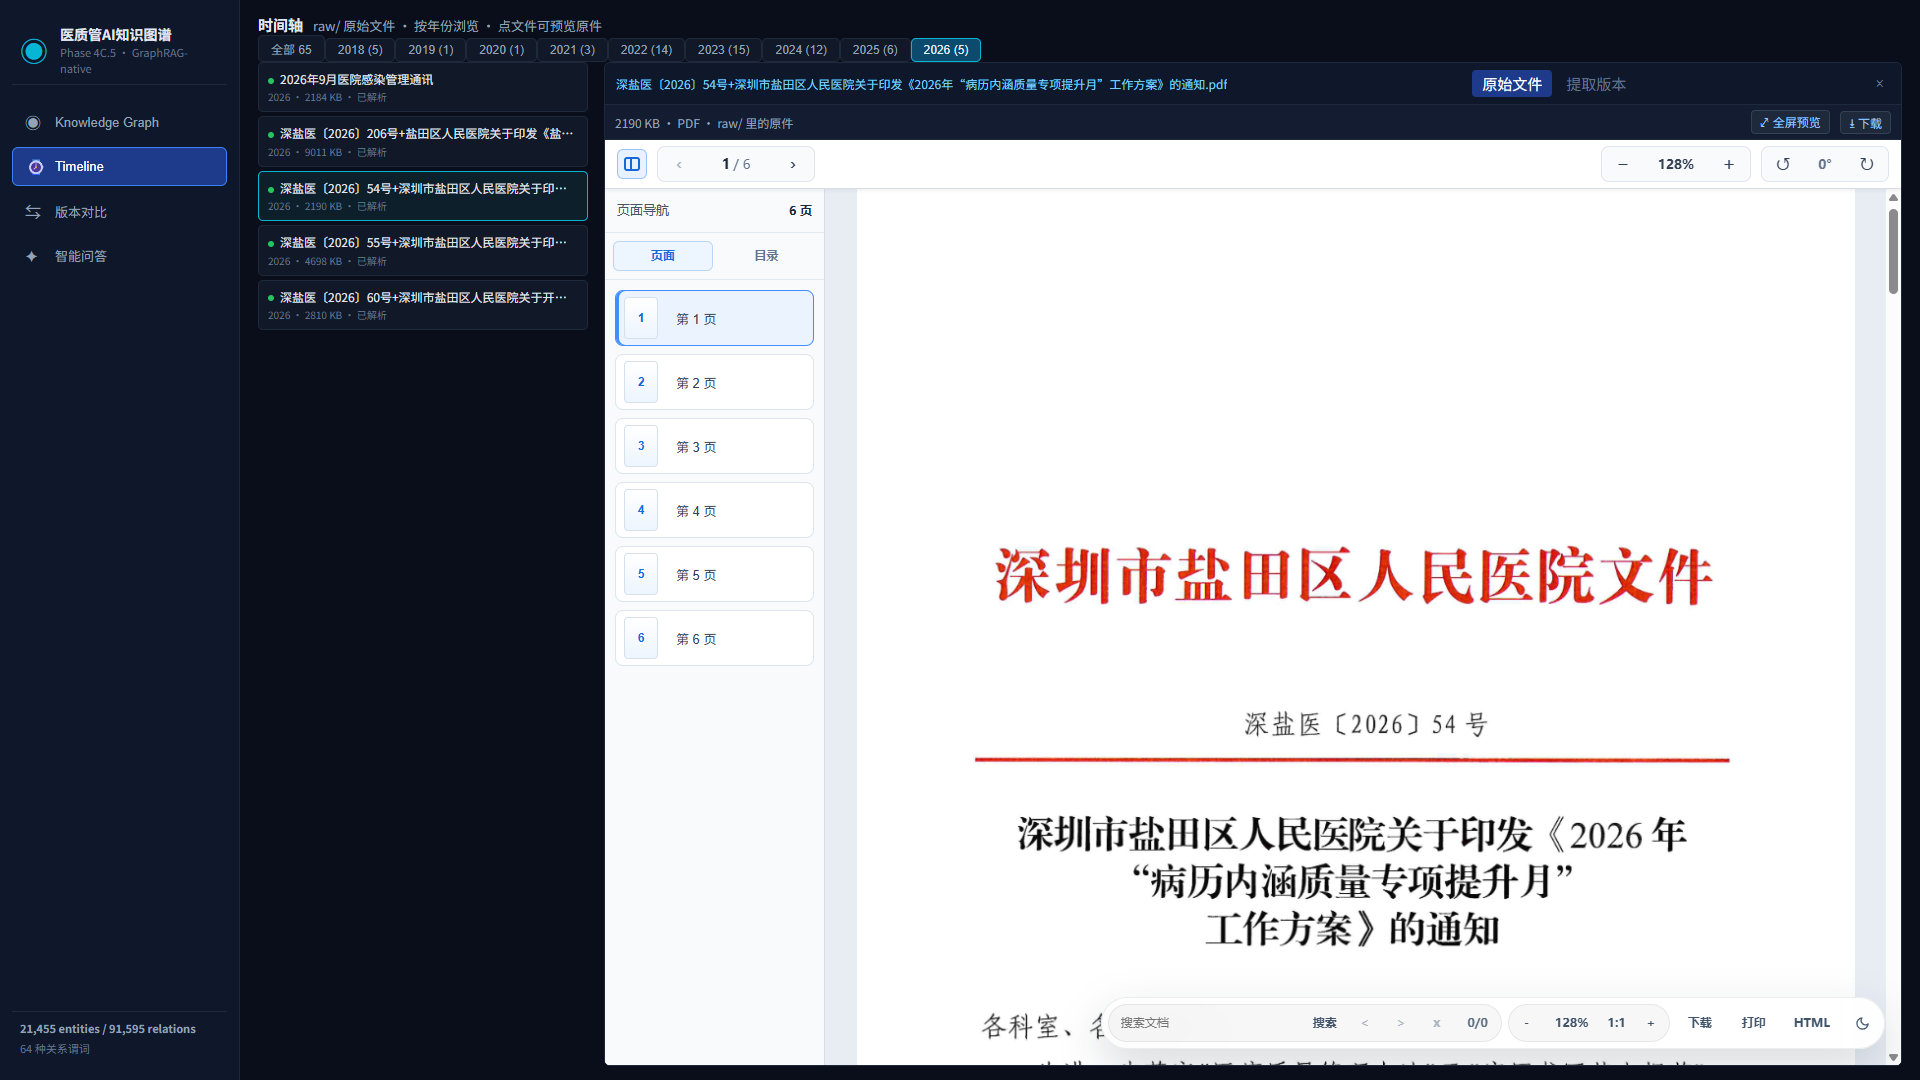
左边是 65 份原始文件按年份排开(2018 年 5 份、2022 年 14 份、2023 年 15 份、2024 年 12 份……),绿点表示已解析。
点开任一份,两个视图切换:
- 原始文件:直接看 PDF 原件
- 提取版本:看机器解析出来的结构化文本
这两个视图并存,让我能随时怀疑机器:如果提取版本和原件对不上,一眼就能发现。
4.3 制度版本对比
前面 Part 3.6 讲透了。补一句使用场景:
医务科要写”2024 年新版临床路径与 2021 年的主要差异说明”,以前这活儿是两个人对着两份 PDF 逐条比对,两天。现在是先出条款级差异清单,人工只复核”未配对”和”指标变更”这两类。
4.4 智能问答
前面 Part 1 已经看了。再说一个我觉得更重要的细节:
答案里会主动说”不知道”。
比如问”证据中未提及任何允许超时完成入院记录的豁免情形”——它没有硬凑一条出来。
这是 prompt 里反复约束 + 只喂检索到的证据的结果。一个会承认不知道的质管助手,比一个什么都敢答的助手有用一百倍——因为前者你敢拿去回复临床。
Part 5:落地——网站只看,构建留本地
这一段是我在项目后期才想明白的。
5.1 为什么不能把管理功能一起放上去
这套系统里有一堆”能改图”的功能:实体复核、谓词复核、合并别名、重建全链。其中**「重建图谱」这一个按钮,点下去会 MATCH (n) DETACH DELETE n 清空整张图,然后重跑全链**。
我把它放在内网服务器上、给全院同事开放——这不叫方便,这叫在办公室里放了一个能拆房子的按钮。
所以最终形态是:同一套代码,两种模式。
| 本地开发机 | 内网服务器 | |
|---|---|---|
| 启动 | APP_MODE=local(默认) |
APP_MODE=showcase |
| 前端构建 | npm run build |
npm run build:showcase |
| 侧边栏菜单 | 10 个 | 4 个 |
| 管理类接口 | 全部注册 | 13 条物理不注册 |
| 「重建图谱」按钮 | 有 | 无 |
5.2 关键:不是藏菜单,是后端不注册
这是我最想强调的一点。
前端把菜单藏起来,等于没锁——任何人直接在浏览器地址栏敲 /api/graph/rebuild?confirm=true,照样能把图谱清了。
所以后端在 showcase 模式下根本不注册那 13 条路由:
1 | /api/graph/rebuild 404 /api/graph/merge 404 |
敲 URL 也是 404。
而且前端也配合:管理页面改成动态 import,showcase 构建产物里根本不含那些组件的代码,不是”菜单藏了但代码还在包里”。
顺便说一句,这两侧的开关必须成对设置。只设一个,就会出现”菜单少了接口还在”或者”菜单还在接口 404”的尴尬局面。
5.3 服务器上的实际形态
内网 192.168.3.100,Ubuntu 24.04,没 Docker,所以是”venv + 官方二进制包 + systemd”:
1 | 浏览器 → nginx :8003 ─┬─ 静态: /opt/hospitalkg/scripts/25_graph_app/static |
三个 systemd 服务(hospitalkg-web / hospitalkg-neo4j / hospitalkg-qdrant),全部开机自启。
这台服务器上已经有三个别的系统在跑(三甲指标录入查询系统、《质境猎人》、质管通),前端端口占着 8000/8001/8002,后端占着 3000/3001/3002。我全部避开,用了 8003 / 3003 / 7687 / 6333。部署完挨个复查了一遍那三个系统——都还是 200,没碰过人家。
5.4 数据怎么过去:单向同步
服务器上的数据不是让人去服务器上重建的,是本地构建完同步过去的:
1 | 本地(构建) 服务器(只读展示) |
单向:本地 → 服务器。服务器永远不回写。
这里也有个教训:原本想用 Qdrant 的 snapshot 机制,结果发现 4699 个点的 snapshot 居然有 516MB(段没合并),换 scroll API 导出只有 22MB——23 倍差距。
5.5 部署踩的坑(挑三个最有代表性的)
坑一:Neo4j 官方下载源全站 403。
dist.neo4j.org 在这台机器上整个 CloudFront 策略把我们挡在外面;华为云、阿里云的镜像站里没有 neo4j 这个仓库(页面是 SPA,访问任何路径都返回 200,但那不是文件——这个假阳性让我绕了半小时)。
最后是直接打它的 S3 origin bucket 通了的:
1 | https://s3.eu-west-1.amazonaws.com/dist.neo4j.org/neo4j-community-5.26.0-unix.tar.gz |
而且跨境链路只有 30KB/s,151MB 要跑 85 分钟 → 写了 16 路并发分片下载。curl 的 --speed-limit/--speed-time 能熔断”连接还在但不下数据”的挂死,这个参数救了我两次。
坑二:Qdrant 1.19 的 upsert 格式,错一个字符就静默失败。
我用 POST + 新格式,接口返回 ok,但点还是 0 个——不报错、不写数据。实测五种格式之后才找到:1.19 要用 PUT + 旧格式 {"points":[...]}。
静默失败比报错可怕得多,因为它让你以为数据进去了。
坑三:llm_generate 里藏着一个 Windows 假设。
原来的实现是 subprocess.run(["cmd", "/c", "mmx", ...])——mmx 是我本地装的命令行工具。搬到 Linux 上,服务器既没有 cmd 也没有 mmx,问答就永远是 [LLM 生成失败,仅展示检索证据]。
改成 DashScope SDK 直连为主、mmx 为 Windows 回退,两个平台行为一致。
还有一个坑值得单说:nginx 要给 .mjs 单独 MIME。
Ubuntu 的 mime.types 里没有 .mjs,nginx 默认给 application/octet-stream,浏览器按规范”Strict MIME type checking”直接拒绝加载 pdf.worker.mjs → PDF 预览的 worker 起不来,页面一片空白。
修法是加一个 location:
1 | location ~* \.mjs$ { |
★ 注意别用 types 块——那会覆盖继承的其它类型。改完之后浏览器还缓存着旧的错误响应,得清一次缓存才生效。
Part 6:局限、代价,以及几句必须说清楚的大实话
写技术文章最容易犯的错,是把踩过的坑全写成”我已经解决了”。
所以这一节是专门用来泼冷水的。
6.1 版本对比的配对率,并不好看
上面那张《临床路径》2021 vs 2024 的截图,注意看标签栏:
1 | 全部 99 | 指标变更 2 | 修改 1 | 微调 9 | 未配对 52 | 未变 37 |
99 条里,有 52 条是”未配对”。 配对率刚过一半。
原因是两版体例差异太大(2021 版是 markdown 体例的”一、/(一)/1.”,2024 版是公文体的”第X篇/章/节”),条款切出来的东西形态就不一样,文字相似度自然上不去。
我能做的是:把这 52 条明明白白标成”未配对”,让人知道”这 52 条机器没配上,需要人工看”,而不是伪装成”未变”或者”废止”。
但它确实不够用。 真正要交付一份完整的差异说明,这 52 条还是得人看。
我现在在试的办法是章节级对齐(先把两版的章节配上,再在章节内配条款),单测里有过一次好的结果(2021 vs 2022 章节配对 24/25 全对),但整体实测反而更差——因为章节级配对本身就少,一约束就把款级也限死了。所以我把它关掉了,留着参数,等哪天章节配对够好再开。
教训:任何”看起来更严谨”的对齐约束,都要先在真实多组数据上量化对比(配对数 + 高质量配对数),不能凭直觉上线。
6.2 问答会答错,而且一定会答错
大模型会编。用了这么多层检索、这么多约束,它仍然会:
- 把两条制度的条款拼成一个不存在的规定
- 把”未配对”当成”没规定”
- 对没有证据的问题给一个听起来合理的答案
这个系统不能替代人做判断,只能替人省时间。
我的心理预期是:它负责把 30 分钟的翻找变成 30 秒的定位 + 10 分钟的人工确认。 不是”不用看原文了”。
所以溯源不是加分项,是及格线。答不出出处的答案,在质管办是没有使用价值的。
6.3 图谱的质量,受限于抽取的质量
官方 NER 不校验输出类型。我实测过:传进去 21 类实体类型,LLM 照样产出”章节””地理单元””数量描述”这类表外类型——最终图上出现 216 种类型,其中 195 种是表外的,有 685 个实体落进了”其他”。
这不是 bug,是 LLM 的本性。治理办法是加一层类型归一(关键词 → 受控类型,33 条规则),但归一只能收敛,不能凭空补出关系。抽不出来的东西,图上就是没有。
6.4 它是持续工程,不是一次性项目
制度换一版,意味着:
- 原文重新解析(跳过已解析的,这是必须的优化)
- 重新抽取、重新建图、重新推理溯源
- 重新做版本对比(新版本 vs 哪个旧版本比,这个决定也要人来定)
这是一整套以小时计的全量重跑。日常只加一份文件时走增量,快得多。
所以这不是”做完就放那儿”的东西。 它更像一个需要养的系统:制度更新了,它得跟上。
6.5 数据边界
raw/ 里是 65 份院内文件,303MB,全部是院内制度原文,有些还带文号。基本上还处于“测试”通过的状态,要补充的制度、流程、方案、通报、上级通知……还有七千多份待补充啊啊啊
所以这套东西只能在院内跑,不能上公网。部署版放在内网服务器、只读、访问留痕(谁在什么时候看了哪份文件,都记在日志里)——这是质管办的合规要求,不是技术洁癖。
6.6 还有一个”半成品”在那儿
国家医疗质量安全目标方案是逐年增删的:有的目标被移除,有的目标是新增的,而目标名跨年极稳定。
我单独抽了目标清单来做对比(因为条款级配对接不上),这个能精确回答”这几年国家目标增了哪些、删了哪些、改了名”。
但**”目标”和”实际指标值”之间还差最后一环**。年度方案里写”提高急性ST段抬高型心肌梗死再灌注治疗率”,而质量通报里的实际指标叫”急性ST段抬高型心肌梗死再灌注治疗率”——只差一个前缀,但因为它们类型不同,归一的时候合不到一起,闭环断在半路。
我做了目标名归一(带”提高/降低”前缀的并入基础名),合掉了 35 个。但剩下的那些,还需要更细的规则。这一环我还没做完。
Part 7:给同行的三点提示
如果你也在医院里折腾这类东西,下面三条是我踩了坑之后才想明白的:
提示一:先把”答案要能点回原文”写进需求
这句话看起来像锦上添花,实际上它决定了整个系统的架构。
如果只要求”能搜到”,那你做全文检索就行,一周的事。
但一旦要求”答案必须能溯源到具体哪份文件的哪一块”,它就会逼着你:
- 在分块的时候就把”块”这个概念立住(检索粒度、向量粒度、引用粒度必须一致)
- 在建图的时候保留原始 chunk_id(而不是只留实体名)
- 在生成的时候强制模型引用
这三个约束,会在第一天就影响你的数据模型。 等做完了才发现要溯源,那是要重写的。
提示二:警惕”0 违规””0 冲突”这类输出
我的项目里踩过三次同样的坑:结果为空,到底是”真的没有”,还是”键没对上””被 except 吞了””规则太松”?
三次的现场都一样:
- 一次是”0 条关系” —— 其实是谓词判定规则写错,2646 条被吃成 25 条
- 一次是”图谱是空的” —— 其实是磁盘满导致官方 API 超时重试,建了两份节点
- 一次是”所有条款都未变” —— 其实是压根没配对上
在质管办,”我不知道”是一个可以交付的答案;”0 违规”不是。
所以我现在的做法是:每加一条新规则,都要用真实数据去验证它是不是真的在生效,而不是看它返回了什么。
提示三:把”做不了”的部分,老老实实标出来
版本对比里”未配对 52 条”,比错的版本里”未变 52 条”有用得多。
不可比的对比组我直接拆掉,不做;纯表格文件做不了条款级对比,我显式跳过;替代关系原文没写”即日作废”,我就不建边,旧版状态写”已被修订”。
这些”缺口”在系统里是显式可见的标签,而不是被抹平的假象。
因为最终要拿着这份东西去汇报、去回复临床科室的是人。而人做判断的前提,是数据没有在骗他。
写在最后
一整套流水线,21455 个实体,91595 条关系,10 个制度 16 组版本对比,一个能在 1.2 秒给出带出处的答案的内网站点。
但说实话,让我觉得值的不是这些数字。
是当临床科室再打电话来问”入院记录超时怎么罚”的时候,我能直接在图上点开那份制度,翻到那一页,把答案发过去——而不是先花半小时在 300MB 的 PDF 里大海捞针。
工具的价值,不在它多聪明,在它让一件每天都要做很多遍的事,变得不那么费人。
[!TIP] 如果你想试试
这套东西已经部署在院内服务器上(内网地址,只读展示版)。
完整的架构说明、端口规划、以及 18 条部署时踩过的坑,都写在项目仓库的deploy/README.md里。
等我再继续完善几个版本后会放到 github 源代码开源,让想用的同行少走弯路。也欢迎在评论区聊聊:
你们院的制度文件,是怎么管的?
是共享盘 + 各人自搜,还是有别的办法?
我特别想听听制度换版的时候,你们怎么确认”到底改了哪些”——这个问题,在我这里目前还只能做到”标出 52 条未配对,需要人工看”。
 微信
 支付宝